Herramientas Informaticas

Autor: juliocesar20200413 Página 1 de 143

Desarrollador web apasionado y gusto por la buena musica

Cómo instalar y compilar obs-face-tracker en Linux (Arch / CachyOS) para OBS 30+ y Qt6

Entrada fija

Tener un encuadre dinámico que siga tus movimientos o haga zoom al rostro automáticamente al hablar aporta dinamismo a cualquier transmisión o grabación. En Windows existen herramientas privativas de control PTZ virtual, pero en distribuciones basadas en Arch Linux (como CachyOS, Manjaro o EndeavourOS) el estándar abierto es el plugin obs-face-tracker.

Al compilar este complemento en sistemas actualizados con GCC moderno, OBS 30+ y Qt6, surgen dos problemas críticos: advertencias tratadas como errores en la librería interna dlib, y un fallo de segmentación (SIGSEGV) al iniciar OBS debido a llamadas incompatibles con la interfaz gráfica de docks.

En esta guía resolveremos ambos errores compilando, parcheando e instalando el plugin desde el código fuente, optimizado y probado en entornos Wayland con procesadores AMD Ryzen.

1. Requisitos previos y dependencias

Instala las herramientas de compilación, las cabeceras de desarrollo de OBS Studio y la librería de visión artificial OpenCV:

Bash

sudo pacman -S --needed base-devel cmake git opencv obs-studio

Verifica que OpenCV esté accesible en tu terminal:

Bash

opencv_version

2. Clonar el repositorio con submódulos

El proyecto requiere submódulos internos (como dlib y librerías VISCA). Clónalo con el parámetro --recursive:

Bash

cd ~
git clone --recursive https://github.com/norihiro/obs-face-tracker.git
cd obs-face-tracker

3. Parchear el fallo de segmentación (SIGSEGV en Qt6)

El plugin incluye código heredado para crear un Dock (panel flotante para cámaras PTZ por hardware). En versiones modernas de OBS que corren sobre Qt6, la llamada ft_docks_init() provoca un cierre inmediato (SIGSEGV) de OBS al iniciar.

Como solo necesitamos el filtro de seguimiento facial en la cámara, desactivamos la inicialización del dock haciendo que el módulo reporte una carga exitosa directa:

Bash

# Modificar src/module-main.c para omitir la carga del dock problemático
sed -i 's/ft_docks_init();/return true;/g' src/module-main.c
sed -i 's/ft_docks_destroy();/\/\/ ft_docks_destroy();/g' src/module-main.c

Para comprobar que el cambio se aplicó correctamente, ejecuta:

Bash

git diff src/module-main.c

Deberás ver que return ft_docks_init(); fue sustituido por return true;.

4. Configurar CMake y compilar sin bloqueos de advertencias

Por defecto, el compilador en CachyOS trata cualquier variable no usada dentro de dlib como un error fatal (-Werror). Pasamos el parámetro -w tanto para C como para C++ en CMake para silenciar advertencias en código de terceros y compilar con todos los hilos del CPU:

Bash

# Configuración del proyecto
cmake -B build -S . \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_INSTALL_PREFIX=/usr \
  -DCMAKE_C_FLAGS="-w" \
  -DCMAKE_CXX_FLAGS="-w"

# Compilación paralela
cmake --build build -j$(nproc)

La terminal debe finalizar con:

Plaintext

[100%] Built target obs-face-tracker

5. Instalación manual en las rutas estándar de OBS

El instalador por defecto de este repositorio coloca archivos en rutas obsoletas (/usr/obs-plugins/). Para que OBS Studio reconozca el plugin en distribuciones basadas en Arch, copia los binarios y datos a las rutas del sistema:

Bash

# Copiar la librería compartida
sudo cp build/obs-face-tracker.so /usr/lib/obs-plugins/

# Crear la carpeta de datos y copiar las traducciones
sudo mkdir -p /usr/share/obs/obs-plugins/obs-face-tracker/locale
sudo cp -r data/locale/* /usr/share/obs/obs-plugins/obs-face-tracker/locale/

Comprueba que el archivo exista:

Bash

ls -lh /usr/lib/obs-plugins/obs-face-tracker.so

6. Configuración del filtro en OBS Studio

Inicia OBS Studio (puedes lanzarlo desde la terminal con el comando obs para verificar que no emita advertencias):

  1. Añadir el filtro:
    • En tu escena, localiza la fuente de tu cámara web (Dispositivo de captura de video (V4L2)).
    • Haz clic derecho sobre ella y selecciona Filtros.
    • En la sección inferior izquierda (Filtros de efecto), presiona el botón + y elige Face Tracker.
  2. Calibrar los parámetros:
    • Zoom / Scale: Ajusta el nivel de acercamiento deseado (un valor moderado permite reencuadrar cabeza y hombros sin perder nitidez).
    • Smoothing (Suavizado): Configúralo entre 400 ms y 600 ms. Un valor bajo causará micro-temblores con cada parpadeo; un valor muy alto creará retraso al moverte.
    • Deadzone (Zona muerta): Establécelo entre 10% y 15% para que pequeños cambios de postura no desplacen el lienzo innecesariamente.

7. Configurar un atajo de teclado para activar el zoom

Para usar el acercamiento como un efecto dinámico durante transmisiones o videos explicativos:

  1. Ve a Ajustes > Atajos.
  2. Escribe el nombre de tu cámara en el buscador.
  3. Localiza los campos:
    • Mostrar filtro ‘Face Tracker’
    • Ocultar filtro ‘Face Tracker’
  4. Asigna la misma tecla rápida (por ejemplo, F9 o una combinación de tu teclado/stream deck) para alternar el zoom a demanda.

Ficha técnica y metadatos para WordPress

  • Título SEO: Cómo compilar obs-face-tracker en Arch Linux / CachyOS (Solución SIGSEGV y Qt6)
  • Slug sugerido: instalar-obs-face-tracker-arch-linux-cachyos
  • Categorías: Linux, Streaming & OBS, Software Libre
  • Etiquetas: OBS Studio, CachyOS, Arch Linux, Face Tracking, OpenCV, AMD Ryzen
  • Extracto: Guía paso a paso para compilar y hacer funcionar el plugin obs-face-tracker en Linux moderno, resolviendo los errores de compilación con GCC y el cierre por SIGSEGV en entornos Qt6 y Wayland.

🚨 ¿Te están cobrando seguros fantasma en tu tarjeta? La verdad sobre las Fintech y cómo hackear tus fechas de pago 💳⚡

Entrada fija

¿Te ha pasado que tramitas una tarjeta “sin anualidad y con cashback jugoso”, pero de repente tu saldo no cuadra? 🤔 Bienvenido al club de los débitos silenciosos.

Mientras las apps nos deslumbran con colores pastel y trámites en 3 minutos, detrás de escena algunas aplican patrones oscuros (dark patterns) para colar seguros, coberturas y membresías automáticas (como el famoso Plata Protege o Plata+ en Plata Card, o las asistencias “de cortesía” de la banca tradicional) 💸👻.

🕵️‍♂️ La trampa maestra: ¿Por qué tu celular nunca vibra?

Seguro piensas: “Si me cobraran algo raro, me llegaría una notificación push al instante”. Falso. ❌

  • 🛒 Cuando compras en el súper: La transacción viaja por Visa o Mastercard y la app te manda un aviso en milisegundos.
  • 📋 Cuando te cobran un seguro o comisión: Es un asiento contable interno del propio banco. No pasa por la red de pagos externa, así que no detona alertas en tu teléfono.
  • 📄 El truco legal: Por ley, solo están obligados a plasmarlo en tu estado de cuenta en PDF. Si eres de los que nunca descarga el PDF mensual… felicidades, llevas meses pagando la fiesta del banco sin enterarte 🥂.

🗓️ El Hack definitivo: Cómo estirar tus compras hasta 50+ días sin pagar intereses 🧠💡

Si vas a usar tarjetas de crédito, que el financiamiento trabaje para ti, no al revés. La matemática de calendario es simple:

  • 🔴 Comprar el día de corte (o 1 día antes): Pésima idea. Entra en el corte inmediato y tienes apenas 20 días para liquidar.
  • 🟢 Comprar el día posterior al corte (Corte + 1): ¡Modo genio activado! 🚀 Tu compra no entra en el ciclo actual, sino en el siguiente. Ganas los 30 días del nuevo ciclo + los 20 días de gracia. ¡Hasta 50 o 55 días de financiamiento libre de intereses!

💻 Nuestra solución: Un Auditor Forense con interfaz Cyberpunk en Python 🦾👾

Para no perder tiempo abriendo PDFs aburridos ni arriesgar contraseñas bancarias en apps sospechosas, armamos una herramienta de escritorio local en Python con estética retro neón y motor dual:

┌─────────────────────────────────────────────────────────┐
│     NEO-FINANCE // AUDITOR FORENSE & OPTIMIZADOR        │
│       Arrastra y suelta tus PDFs (con o sin RFC)       │
└────────────────────────────┬────────────────────────────┘
                             │
            ┌────────────────┴────────────────┐
            ▼                                 ▼
   🤖 IA Local (Ollama)              ⚡ Motor Mecánico
   Qwen 2.5 (14B / 7B)              Expresiones Regulares
   Razonamiento semántico           Cero consumo de CPU/GPU

¿Qué hace este script? 🛠️

  1. 📂 Arrastrar y soltar (Drag & Drop): Arrastras de golpe los PDFs de Banorte, Santander, Citibanamex, Nu, Stori o Plata Card directo al programa.
  2. 🔓 Desencriptado inteligente: Si el banco le metió candado con tu RFC, la terminal abre un portal retro seguro, lo descifra en memoria y recuerda la clave para el lote.
  3. 🎯 Semáforo diario de tarjetas: Te dice exactamente cuál tarjeta te da más días libres de pago hoy (marcando en neón cian el plástico ganador y en rojo alerta las que están por cortar).
  4. 🚨 Visor forense de cargos fantasma: Escanea renglón por renglón y separa las compras reales de cobros indebidos (anualidades no avisadas, seguros y membresías), dejando fuera los intereses habituales.
  5. 🌐 100% privado y offline: Tus datos no tocan ningún servidor externo; todo se procesa en tu propia máquina.

🛡️ Checklist de supervivencia financiera (¡Aplícalo hoy!)

  • [ ] Entra a tu app bancaria y apaga cualquier interruptor de asistencia vial, seguro de vida o protección de saldo.
  • [ ] Descarga religiosamente tus estados de cuenta cada mes y busca la palabra “Comisiones”.
  • [ ] Si ves cobros no autorizados, mete aclaración ante la UNE del banco: por ley tienes hasta 90 días naturales para exigir tu reembolso completo.
  • [ ] Programa recordatorios en tu calendario para comprar solo a partir de tu Corte + 1.

🚀 De 1 Video Largo a 15 Shorts Virales: Mi Pipeline 100% Local con Python, Whisper y Qwen 2.5

Entrada fija

¿Terminaste de grabar un tutorial técnico de más de una hora y te da pereza abrir Kdenlive o DaVinci Resolve para sacar clips? 😫✂️

Editar clips verticales manualmente para YouTube Shorts o TikTok consume horas de trabajo repetitivo: buscar momentos interesantes, recortar silencios, reencuadrar a formato vertical 9:16, desenfocar el fondo y subtitular palabra por palabra. Las herramientas SaaS en la nube como OpusClip cobran suscripciones mensuales recurrentes y suben tus grabaciones privadas a servidores externos. 💸🔒

La alternativa definitiva es montar tu propio pipeline automatizado de código abierto que corre al 100% en local. Con un solo script en Python, el sistema:

  1. Detecta si tu grabación se dividió en dos partes y las une sin pérdida de calidad.
  2. Analiza los canales de audio y aísla la pista limpia de tu micrófono (pista 2 de OBS).
  3. Elimina pausas muertas con auto-editor.
  4. Transcribe todo el audio con faster-whisper.
  5. Envía la transcripción completa a qwen2.5:14b vía Ollama para extraer de 10 a 15 ganchos virales en JSON estricto.
  6. Renderiza en lote los videos en formato vertical (9:16), con fondo desenfocado, título superior, subtítulos amarillos y metadatos incrustados.

📦 Requisitos previos en el sistema

Antes de ejecutar el script en tu distribución Linux, asegúrate de tener las dependencias listas:

Bash

# Herramientas base y modelos
sudo pacman -S ffmpeg   # En CachyOS / Arch (o apt install ffmpeg en Ubuntu/Debian)
pip install faster-whisper auto-editor

# Descarga del modelo en Ollama
ollama pull qwen2.5:14b

💻 El Código Completo (pipeline_ia_shorts.py)

Guarda este script en la carpeta donde tengas tus grabaciones (video.mp4 o video2.mp4):

Python

#!/usr/bin/env python3
import json
import os
import re
import subprocess
import urllib.request
from faster_whisper import WhisperModel

# --- CONFIGURACIÓN ---
VIDEO_BASE = "video.mp4" if os.path.exists("video.mp4") else "1.mp4"
VIDEO_EXTRA = "video2.mp4" if os.path.exists("video2.mp4") else ("2.mp4" if os.path.exists("2.mp4") else None)
VIDEO_PREPARED = "unido.mp4"
VIDEO_CLEAN = "video_ALTERED.mp4"
SRT_OUTPUT = "video_ALTERED.srt"
OUT_DIR = "/home/julioc/Automatizaciones/shorts/global/tutoriales"
OLLAMA_MODEL = "qwen2.5:14b"
OLLAMA_URL = "http://localhost:11434/api/generate"

os.makedirs(OUT_DIR, exist_ok=True)

# 0. DETECCIÓN DE PISTAS DE AUDIO Y UNIÓN DE VIDEOS
print("=" * 60)
print("[0/4] Verificando pistas de audio y videos a unir...")
print("=" * 60)

def count_audio_streams(file_path):
    try:
        cmd = [
            "ffprobe", "-v", "error", "-select_streams", "a",
            "-show_entries", "stream=index", "-of", "csv=p=0", file_path
        ]
        out = subprocess.check_output(cmd).decode().strip()
        return len(out.splitlines()) if out else 0
    except Exception:
        return 1

num_audio = count_audio_streams(VIDEO_BASE)
audio_map = "0:a:1" if num_audio >= 2 else "0:a:0"
print(f"[*] Pistas de audio detectadas: {num_audio} -> Seleccionada: {audio_map} ({'Micrófono pista 2' if audio_map == '0:a:1' else 'Pista principal'})")

if not os.path.exists(VIDEO_PREPARED) and not os.path.exists(VIDEO_CLEAN):
    if VIDEO_EXTRA and os.path.exists(VIDEO_EXTRA):
        print(f"[*] Detectado video adicional: {VIDEO_EXTRA}. Uniendo archivos...")
        with open("lista_unir.txt", "w", encoding="utf-8") as f:
            f.write(f"file '{VIDEO_BASE}'\nfile '{VIDEO_EXTRA}'\n")
        
        cmd_concat = [
            "ffmpeg", "-y", "-f", "concat", "-safe", "0",
            "-i", "lista_unir.txt",
            "-map", "0:v:0", "-map", audio_map,
            "-c", "copy", VIDEO_PREPARED
        ]
        subprocess.run(cmd_concat, check=True)
        os.remove("lista_unir.txt")
    else:
        print(f"[*] Procesando solo {VIDEO_BASE} con audio {audio_map}...")
        cmd_extract = [
            "ffmpeg", "-y", "-i", VIDEO_BASE,
            "-map", "0:v:0", "-map", audio_map,
            "-c", "copy", VIDEO_PREPARED
        ]
        subprocess.run(cmd_extract, check=True)
else:
    print(f"[!] Reutilizando archivo preparado existente...")

# 1. CORTE DE SILENCIOS CON AUTO-EDITOR
print("\n" + "=" * 60)
print("[1/4] Cortando silencios (>5s) con auto-editor...")
print("=" * 60)

input_for_autoeditor = VIDEO_PREPARED if os.path.exists(VIDEO_PREPARED) else VIDEO_BASE
if not os.path.exists(VIDEO_CLEAN):
    cmd_autoeditor = [
        "auto-editor", input_for_autoeditor,
        "--edit", "audio:threshold=4%,mincut=5s",
        "-o", VIDEO_CLEAN
    ]
    subprocess.run(cmd_autoeditor, check=True)
else:
    print(f"[!] Archivo {VIDEO_CLEAN} ya existe, reutilizando...")

# 2. TRANSCRIPCIÓN CON FASTER-WHISPER
print("\n" + "=" * 60)
print("[2/4] Verificando / generando subtítulos...")
print("=" * 60)

srt_text_dump = []
if not os.path.exists(SRT_OUTPUT):
    whisper_model = WhisperModel("small", device="cpu", compute_type="int8")
    segments, _ = whisper_model.transcribe(VIDEO_CLEAN, language="es")

    srt_entries = []
    for idx, seg in enumerate(segments, 1):
        t_start = f"{int(seg.start//3600):02d}:{int((seg.start%3600)//60):02d}:{int(seg.start%60):02d},000"
        t_end = f"{int(seg.end//3600):02d}:{int((seg.end%3600)//60):02d}:{int(seg.end%60):02d},000"
        srt_entries.append(f"{idx}\n{t_start} --> {t_end}\n{seg.text.strip()}\n")
        
        clean_start = f"{int(seg.start//3600):02d}:{int((seg.start%3600)//60):02d}:{int(seg.start%60):02d}"
        srt_text_dump.append(f"[{clean_start}] {seg.text.strip()}")

    with open(SRT_OUTPUT, "w", encoding="utf-8") as f:
        f.write("\n".join(srt_entries))
else:
    print(f"[!] Usando {SRT_OUTPUT} existente...")
    with open(SRT_OUTPUT, "r", encoding="utf-8") as f:
        lines = f.readlines()
    for i, line in enumerate(lines):
        if "-->" in line and i + 1 < len(lines):
            t_raw = line.split("-->")[0].strip().split(",")[0]
            txt = lines[i+1].strip()
            if txt:
                srt_text_dump.append(f"[{t_raw}] {txt}")

# 3. EXTRACCIÓN MASIVA CON QWEN 2.5 (10 A 15 CLIPS)
print("\n" + "=" * 60)
print(f"[3/4] Extrayendo entre 10 y 15 momentos virales con {OLLAMA_MODEL}...")
print("=" * 60)

prompt_analysis = f"""Eres un editor profesional de contenido en formato vertical (Shorts/TikTok).
Analiza detalladamente toda la transcripción y extrae OBLIGATORIAMENTE entre 10 y 15 momentos clave.

INSTRUCCIONES CRÍTICAS:
1. Cuota obligatoria: Mínimo 10 clips, máximo 15 clips. NO entregues menos de 10.
2. Cada clip debe durar entre 30 y 75 segundos.
3. Cubre TODO el video: extrae clips del inicio, de la parte media y del final.
4. Formato de timestamps: "HH:MM:SS" (estricto).
5. Títulos: En MAYÚSCULAS, breves, sin dos puntos ni comillas.
6. Campo filename: alfanumérico con guiones bajos (ej. "01_TITULO", "02_TITULO").

Devuelve EXCLUSIVAMENTE el arreglo JSON:
[
  {{
    "start": "00:00:45",
    "end": "00:01:35",
    "filename": "01_TITULO_RESUMEN",
    "title": "TITULO EN MAYUSCULAS",
    "desc": "Descripcion corta para metadatos"
  }}
]

Transcripción:
{chr(10).join(srt_text_dump)}
"""

payload = {
    "model": OLLAMA_MODEL,
    "prompt": prompt_analysis,
    "stream": False,
    "format": "json",
    "options": {
        "num_ctx": 16384,
        "num_predict": 4096,
        "temperature": 0.2
    }
}

req = urllib.request.Request(
    OLLAMA_URL,
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"}
)

with urllib.request.urlopen(req) as resp:
    res_data = json.loads(resp.read().decode("utf-8"))
    raw_response = res_data.get("response", "[]").strip()

if raw_response.startswith("```"):
    raw_response = re.sub(r"^```(?:json)?\s*", "", raw_response)
    raw_response = re.sub(r"\s*```$", "", raw_response)

try:
    parsed = json.loads(raw_response)
    clips = parsed.get("clips", parsed) if isinstance(parsed, dict) else parsed
except Exception as err:
    print(f"[!] Error procesando JSON de Ollama: {err}")
    print("Respuesta recibida:\n", raw_response)
    exit(1)

print(f"[✓] La IA detectó con éxito {len(clips)} segmentos.")

# 4. RENDERIZADO VERTICAL CON FFMPEG
print("\n" + "=" * 60)
print(f"[4/4] Renderizando {len(clips)} shorts en {OUT_DIR}...")
print("=" * 60)

for idx, clip in enumerate(clips, 1):
    start = clip["start"]
    end = clip["end"]
    fname = re.sub(r'[^a-zA-Z0-9_-]', '_', clip["filename"])
    title = clip["title"].replace(":", "\\:").replace("'", "").replace("%", "%%")
    desc = clip.get("desc", title)
    out_file = os.path.join(OUT_DIR, f"{fname}.mp4")

    print(f"\n[>] Short {idx}/{len(clips)}: {clip['title']}")
    print(f"    {start} -> {end}")

    filter_complex = (
        "[0:v]split=2[bg][fg];"
        "[bg]scale=1080:1920:force_original_aspect_ratio=increase,crop=1080:1920,avgblur=30[bg_b];"
        "[fg]scale=1080:-1[fg_s];"
        "[bg_b][fg_s]overlay=(W-w)/2:(H-h)/2,"
        f"drawtext=expansion=none:text='{title}':font='Liberation Sans\\:style=Bold':fontcolor=white:fontsize=38:bordercolor=black:borderw=4:shadowcolor=black@0.6:shadowx=2:shadowy=2:x=(w-text_w)/2:y=240,"
        f"subtitles='{SRT_OUTPUT}':force_style='PlayResX=1080,PlayResY=1920,FontSize=42,FontName=Liberation Sans,Bold=1,PrimaryColour=&H0000FFFF,OutlineColour=&H00000000,BackColour=&H80000000,BorderStyle=1,Outline=3,Shadow=2,Alignment=2,MarginV=180',"
        "setpts=PTS-STARTPTS[v]"
    )

    cmd_ffmpeg = [
        "ffmpeg", "-y",
        "-ss", start,
        "-to", end,
        "-copyts",
        "-i", VIDEO_CLEAN,
        "-filter_complex", filter_complex,
        "-map", "[v]",
        "-map", "0:a:0",
        "-af", "asetpts=PTS-STARTPTS",
        "-c:v", "libx264",
        "-preset", "veryfast",
        "-crf", "18",
        "-c:a", "aac",
        "-metadata", f"title={clip['title']}",
        "-metadata", f"description={desc}",
        "-metadata", "artist=Julio Cesar",
        "-metadata", "genre=Technology / Linux Tutorial",
        out_file
    ]
    subprocess.run(cmd_ffmpeg, check=True)

print("\n" + "=" * 60)
print(f"[✓] Proceso completado: se generaron {len(clips)} shorts.")
print(f"[✓] Ruta: {OUT_DIR}")
print("=" * 60)

🔍 Los 3 Trucos Técnicos que Hacen Funcionar este Script

  1. Auto-detección con ffprobe: Grabar con OBS suele generar la pista 1 (escritorio/audio del juego) y la pista 2 (micrófono). La función count_audio_streams() analiza los metadatos y asegura que Whisper y los videos procesen la voz limpia.
  2. Ventana de contexto de 16k y num_predict: 4096: Por defecto, Ollama utiliza ventanas reducidas que truncan la respuesta y provocan que solo se genere 1 clip. Ajustar estos dos parámetros permite al modelo leer transcripciones largas y devolver un archivo JSON con más de 10 elementos sin romperse.
  3. Filtro FFmpeg 9:16 con escape seguro: Los dos puntos (:) y porcentajes (%) rompen la sintaxis de drawtext. El script sanitiza automáticamente los títulos para que ningún carácter especial interrumpa el renderizado.

Ejecuta el script directamente en tu terminal:

Bash

python3 pipeline_ia_shorts.py

Al terminar, tendrás hasta 15 videos verticales listos en tu carpeta con títulos llamativos, subtítulos integrados y metadatos completos para subir a YouTube Shorts y TikTok sin pagar suscripciones. 🐧🚀

📱 ¿Qué datos entregas al registrar tu línea Telcel? INE, CURP, selfie, biométricos y privacidad

Entrada fija

🚨 Registrar tu línea celular ya implica entregar datos personales: esto es lo que debes saber

A partir de los nuevos procesos de registro de usuarios de telefonía móvil, muchas personas tienen una pregunta importante:

🤔 ¿Qué información obtiene Telcel cuando registro mi línea y qué puede hacer con esos datos?

La preocupación es comprensible. Para registrar una línea pueden solicitarse datos de identificación, como el nombre completo y la CURP, así como una identificación oficial. En el caso del registro remoto, Telcel informa que puede solicitarse una prueba de vida o selfie para autenticar a la persona y validar la identificación proporcionada.

Pero el registro de una línea no debe analizarse únicamente desde el punto de vista del trámite.

También es importante preguntarse:

  • 🪪 ¿Qué datos personales estoy proporcionando?
  • 📷 ¿Qué ocurre con mi identificación?
  • 🤳 ¿Para qué sirve la selfie o prueba de vida?
  • 🖐️ ¿Telcel puede tratar datos biométricos?
  • 🏛️ ¿Se pueden validar datos ante el INE?
  • 📡 ¿Qué otros datos puede obtener Telcel después de que uso la línea?
  • 🔐 ¿Puede ver mis fotos y archivos personales?
  • 📢 ¿Puede utilizar mis datos para publicidad?
  • ⚖️ ¿Qué derechos tengo sobre mi información?

En este artículo analizamos el proceso tomando como referencia la información oficial publicada por Telcel sobre el registro de líneas y su Aviso de Privacidad vigente.


📲 ¿Qué necesitas para registrar una línea Telcel?

Según la información oficial publicada por Telcel para el registro de usuarios de telefonía móvil, al realizar el trámite se solicita una identificación oficial vigente que contenga fotografía y CURP.

Entre los documentos mencionados se encuentran:

  • 🪪 Credencial para votar del INE.
  • 🛂 Pasaporte vigente.
  • 🌎 En determinados casos aplicables a personas extranjeras, documentación y CURP correspondientes.

Además, Telcel señala que se proporciona:

  • 👤 Nombre completo.
  • 🔢 CURP.

Si realizas el registro mediante la modalidad remota, también puede solicitarse una prueba de vida o selfie para autenticar tu identidad y validar la identificación presentada.

Esto significa que el registro puede involucrar información mucho más amplia que simplemente asociar un nombre con un número telefónico.


🪪 ¿Qué información personal puede tener Telcel sobre ti?

El Aviso de Privacidad de Clientes de Telcel establece diferentes categorías de datos personales que pueden ser tratados para la prestación de sus servicios.

Entre ellas se encuentran:

  • 🪪 Datos de identificación.
  • 🔐 Datos de autenticación.
  • 📞 Datos de contacto.
  • 💳 Datos patrimoniales y financieros.
  • 🧾 Datos fiscales.
  • 👥 Datos demográficos.
  • 📍 Datos de ubicación.
  • 📡 Información técnica del dispositivo.
  • 🌐 Datos de red.
  • 📊 Datos inferidos.
  • 🛍️ Preferencias de consumo.
  • 🖐️ Datos biométricos, dependiendo del contexto y del tratamiento.

Telcel también publica información complementaria donde explica ejemplos de datos que pueden estar incluidos dentro de estas categorías, como nombre, apellidos, RFC, CURP, fecha de nacimiento, fotografía, firma y datos biométricos, entre otros.

Por eso, cuando registras una línea, no solamente debes pensar en el número telefónico: estás estableciendo una relación de servicio que puede requerir distintos datos para identificación, autenticación, seguridad y cumplimiento de obligaciones.


🤳 ¿Qué pasa con la selfie o prueba de vida?

Uno de los puntos que puede generar más dudas es el registro remoto.

Telcel indica que, si eliges la modalidad remota, puede solicitarse una prueba de vida mediante selfie para autenticarte y validar la identificación oficial proporcionada.

La finalidad principal de este proceso es comprobar que:

  • 👤 La persona que realiza el trámite existe físicamente.
  • 🪪 Coincide con la identidad presentada.
  • 🛡️ Se reduzca el riesgo de fraude o robo de identidad.

Sin embargo, una imagen del rostro utilizada para verificar identidad puede involucrar características biométricas dependiendo de la tecnología y del tratamiento realizado.

El Aviso de Privacidad de Telcel señala expresamente que puede tratar datos biométricos relacionados con huellas dactilares y características del rostro que sean proporcionados voluntariamente para actividades de verificación de identidad, prevención de fraude y operaciones relacionadas con sus servicios.

Esto no significa necesariamente que cualquier fotografía sea automáticamente utilizada como un registro biométrico permanente. El tratamiento concreto depende del proceso utilizado. Pero sí significa que el tema de la verificación facial y biométrica merece atención cuando realizas un trámite de identificación.


🖐️ ¿Telcel puede utilizar huellas y datos biométricos?

El Aviso de Privacidad de Clientes de Telcel establece que los datos biométricos pueden considerarse datos personales sensibles dependiendo del contexto.

Entre los datos mencionados se encuentran:

  • 🖐️ Huellas dactilares.
  • 🙂 Características del rostro.

La finalidad indicada incluye actividades como:

  • Verificación de identidad.
  • Prevención de fraudes.
  • Prevención del robo de identidad.
  • Autenticación para servicios.
  • Operaciones futuras realizadas ante Telcel.

También se establece la posibilidad de verificar ante el Instituto Nacional Electoral (INE) la calidad de los datos contenidos en la Credencial para Votar, incluyendo datos biométricos, conforme a las finalidades descritas en el aviso.

Esta es una de las razones por las que resulta importante leer el aviso de privacidad antes de entregar una identificación o realizar un proceso de autenticación facial.


🏛️ ¿Telcel puede verificar información con el INE?

De acuerdo con su Aviso de Privacidad, Telcel contempla como finalidad primaria:

verificar ante el Instituto Nacional Electoral la calidad de los datos contenidos en la Credencial para Votar, incluyendo datos biométricos.

También contempla transferencias relacionadas con el INE para estos procesos de validación y autenticación de identidad.

En términos simples, cuando utilizas tu credencial para votar en un proceso de identificación, el aviso contempla mecanismos para verificar la información proporcionada.

Esto es importante porque muchas personas piensan que entregar una identificación únicamente significa que un empleado observa físicamente el documento.

Los procesos modernos pueden incluir mecanismos tecnológicos de validación y autenticación, especialmente cuando se trata de prevenir registros fraudulentos o robo de identidad.


🔐 ¿Registrar una línea significa que Telcel puede entrar a mi celular?

No.

Este punto debe quedar muy claro.

Registrar una línea con tu identificación, CURP y otros datos necesarios para validar tu identidad no significa que Telcel reciba acceso automático al contenido almacenado dentro de tu teléfono.

El registro de la línea y el contenido de tu dispositivo son cosas diferentes.

Por ejemplo, registrar tu línea no significa automáticamente que Telcel pueda abrir:

  • 🖼️ Tu galería.
  • 📁 Tus documentos.
  • 🎥 Tus vídeos.
  • 🎵 Tu música almacenada.
  • 🔑 Tus contraseñas.
  • 💬 Tus conversaciones privadas.

El acceso directo a este tipo de información depende de factores diferentes, como las aplicaciones instaladas y los permisos otorgados dentro del sistema operativo.


📸 Entonces, ¿Telcel puede ver mis fotos?

No simplemente por registrar tu línea.

Entregar tu identificación o una selfie para un proceso de autenticación no significa que Telcel tenga acceso completo a toda tu galería.

Una selfie utilizada para verificar identidad es diferente de obtener permiso para navegar por todas las fotografías almacenadas en tu dispositivo.

Para que una aplicación instalada pueda acceder directamente a fotos, vídeos o archivos, normalmente necesita permisos específicos otorgados por Android.

Por eso es importante diferenciar:

🤳 Selfie para registro

Puede utilizarse para autenticar tu identidad durante el proceso.

🖼️ Acceso a la galería

Es un permiso relacionado con el sistema operativo y las aplicaciones instaladas.

Una cosa no implica automáticamente la otra.


📁 ¿Y mis archivos personales?

La misma lógica aplica a tus archivos.

El hecho de tener una línea registrada no permite automáticamente al operador abrir documentos almacenados en:

  • 📂 Descargas.
  • 📄 Documentos.
  • 🖼️ Imágenes.
  • 🎬 Vídeos.
  • 🎵 Música.

Android cuenta con mecanismos de permisos para controlar el acceso de las aplicaciones a este tipo de información.

Por eso, si utilizas aplicaciones relacionadas con Telcel, puedes revisar directamente qué permisos tienen.

Busca:

⚙️ Configuración → Aplicaciones → Nombre de la aplicación → Permisos

Ahí puedes comprobar si una aplicación tiene acceso a:

  • Fotos y vídeos.
  • Archivos.
  • Ubicación.
  • Cámara.
  • Micrófono.
  • Contactos.
  • Teléfono.
  • SMS.

Google explica que Android permite revisar y modificar los permisos otorgados a las aplicaciones desde la configuración del dispositivo.


📡 Después del registro: ¿qué información puede obtener Telcel por el uso del servicio?

Aquí es donde el Aviso de Privacidad cobra especial importancia.

Una vez que utilizas una línea y los servicios de telecomunicaciones, Telcel puede tratar información relacionada con la prestación de esos servicios.

El aviso menciona, entre otros:

  • 📡 Información técnica y de ubicación del dispositivo.
  • 🌐 Datos de la red.
  • 📍 Datos de ubicación.
  • 📊 Datos inferidos.
  • 🛒 Preferencias de consumo.

Esto no debe confundirse con acceso completo al almacenamiento del teléfono.

Por ejemplo:

Saber información técnica relacionada con una conexión no es lo mismo que abrir directamente la carpeta de fotos del usuario.

La diferencia entre los datos generados por el uso de la red y el contenido almacenado dentro del dispositivo es fundamental para entender la privacidad.


🧠 ¿Qué significa que puedan generar datos “inferidos”?

El Aviso de Privacidad también menciona los llamados datos inferidos.

En términos sencillos, son conclusiones o información generada a partir de otros datos disponibles.

Por ejemplo, mediante análisis de información pueden elaborarse:

  • 📊 Perfiles de consumo.
  • 🛍️ Preferencias comerciales.
  • 💳 Evaluaciones relacionadas con comportamiento crediticio.
  • 📈 Segmentaciones.
  • 🎯 Ofertas personalizadas.

El aviso contempla análisis y estudios relacionados con el comportamiento de consumo, así como elaboración de perfiles crediticios para determinar elegibilidad, nivel de riesgo o condiciones aplicables para productos y servicios. También contempla tratamientos automatizados de datos para estas finalidades.


💳 ¿Pueden consultar información relacionada con mi comportamiento crediticio?

Dependiendo del servicio contratado y de las obligaciones relacionadas, el Aviso de Privacidad contempla:

  • Monitoreo del comportamiento crediticio.
  • Elaboración de perfiles crediticios.
  • Evaluación de elegibilidad y nivel de riesgo.
  • Relación con sociedades de información crediticia.
  • Transferencias necesarias conforme a las finalidades y obligaciones aplicables.

Esto puede ser especialmente relevante cuando solicitas:

  • 📱 Un equipo financiado.
  • 📃 Un plan de renta.
  • 💰 Productos o servicios sujetos a evaluación crediticia.

No necesariamente aplica de la misma manera a todos los usuarios ni a todos los tipos de servicio, pero forma parte de las categorías y finalidades descritas en el aviso.


📢 ¿Pueden utilizar mis datos para publicidad?

El Aviso de Privacidad distingue entre finalidades primarias y finalidades secundarias.

Las finalidades primarias están relacionadas con proporcionar el servicio, verificar identidad, prevenir fraude, realizar facturación, cumplir obligaciones y otras actividades necesarias.

Las finalidades secundarias incluyen actividades como:

  • 📣 Envío de promociones.
  • 🎁 Ofertas personalizadas.
  • 🛍️ Información sobre productos y servicios.
  • 📊 Segmentación.
  • 🧠 Perfilamiento.
  • 📈 Predicciones y análisis para fines comerciales.

El aviso también contempla determinadas transferencias a empresas del grupo y, bajo ciertas condiciones y mecanismos de oposición, a socios comerciales o terceros para fines relacionados con productos y servicios.


✋ ¿Puedo decir que no quiero publicidad?

Sí existen mecanismos para limitar determinados tratamientos relacionados con finalidades secundarias.

El Aviso de Privacidad de Telcel señala que la negativa al uso de datos para finalidades secundarias no debe ser motivo para negar los servicios que solicitas o contratas.

También establece procedimientos para ejercer derechos relacionados con tus datos personales y para limitar determinados usos o divulgaciones.

Esto es importante:

📱 Puedes necesitar registrar tu línea para cumplir con el proceso aplicable, pero eso no significa necesariamente que debas aceptar recibir publicidad personalizada para poder utilizar el servicio.


⚖️ Tus Derechos ARCO: ¿qué puedes pedir?

Como titular de datos personales puedes ejercer los conocidos como Derechos ARCO:

🅰️ Acceso

Puedes solicitar conocer qué datos personales tienen sobre ti y cómo son utilizados.

✏️ Rectificación

Puedes pedir la corrección de información incorrecta, incompleta o desactualizada.

🗑️ Cancelación

Puedes solicitar la eliminación de datos cuando resulte legalmente procedente.

✋ Oposición

Puedes oponerte al uso de tus datos para determinadas finalidades.

La legislación mexicana exige que los avisos de privacidad informen, entre otros aspectos, la identidad del responsable, los datos tratados, las finalidades, los mecanismos para limitar el uso de los datos y los procedimientos para ejercer los derechos correspondientes.

Telcel publica en su Aviso de Privacidad los mecanismos para contactar a su Departamento de Datos Personales y ejercer los derechos relacionados con el tratamiento de la información.


🔍 ¿Qué deberías revisar antes de registrar tu línea?

Antes de realizar cualquier proceso de registro, considera estos puntos:

1️⃣ Lee qué datos te están solicitando

Pregunta si se requiere:

  • INE.
  • CURP.
  • Pasaporte.
  • Selfie.
  • Prueba de vida.
  • Huella u otro mecanismo de autenticación.

2️⃣ Pregunta para qué se utilizarán

Un proceso de identificación puede tener finalidades relacionadas con:

  • Seguridad.
  • Prevención de fraude.
  • Autenticación.
  • Cumplimiento normativo.

3️⃣ Consulta el Aviso de Privacidad

El Aviso de Privacidad es el documento que explica qué categorías de datos se tratan y para qué finalidades.

4️⃣ Diferencia entre registro y acceso al teléfono

Entregar tu identificación para registrar una línea no equivale a entregar acceso a tu galería o archivos personales.

5️⃣ Revisa los permisos de las aplicaciones

Si tienes apps de Telcel instaladas, comprueba qué permisos tienen realmente en tu dispositivo.


🛡️ Conclusión: registrar tu línea implica identificarte, no entregar el control completo de tu teléfono

El registro de una línea móvil implica proporcionar información personal para asociar la línea con una persona y realizar procesos de identificación y autenticación.

Según la información publicada por Telcel, el proceso puede requerir identificación oficial, nombre completo y CURP y, en la modalidad remota, una prueba de vida o selfie para validar la identidad.

Por su parte, el Aviso de Privacidad de Telcel contempla el tratamiento de múltiples categorías de información, incluyendo datos de identificación, contacto, ubicación, red, preferencias de consumo y, en determinados contextos, datos biométricos como huellas dactilares y características del rostro.

Sin embargo, hay una diferencia fundamental que todos los usuarios deberían conocer:

📱 Registrar tu línea con tu INE, CURP o una selfie no significa automáticamente que Telcel pueda entrar a tu celular, revisar tu galería, abrir tus archivos o consultar libremente todo lo que tienes instalado.

La información utilizada para registrar y autenticar una línea forma parte de un proceso diferente al acceso al contenido almacenado en el dispositivo.

La mejor recomendación es mantenerse informado, revisar el Aviso de Privacidad vigente, conocer qué permisos tienen las aplicaciones instaladas y ejercer los derechos disponibles cuando sea necesario.


📚 Fuentes oficiales
¿Qué es Navidrome y Cómo Instalarlo Nativamente en CachyOS / Arch Linux 🎵

Entrada fija

Si eres amante de la música y prefieres mantener el control de tu propia colección de archivos MP3, FLAC o WAV, seguro te has topado con este dilema: ¿cómo escuchar tu música local en el celular o la laptop sin andar pasando archivos por USB? 📁📲

Aquí es donde entra Navidrome, una de las mejores herramientas de código abierto para transformar tu PC en tu propio servidor de streaming estilo Spotify. 🎧✨

En este artículo te explicamos qué es, para qué sirve y los comandos paso a paso para instalarlo nativamente en CachyOS (o cualquier sistema basado en Arch Linux).

🚀 ¿Qué es Navidrome?

Navidrome es un servidor de medios y reproductor de música de código abierto, ultraligero y muy rápido. Está diseñado para permitirte explorar y escuchar tu colección de música almacenada en tu computadora o servidor desde cualquier lugar a través de un navegador web o aplicaciones móviles. 🌐🎶

Está escrito en Go, lo que significa que consume muy poca memoria RAM y CPU, rindiendo a la perfección tanto en tu PC de escritorio como en una laptop o Raspberry Pi.

💡 ¿Para qué sirve y por qué deberías usarlo?

  • Centralizar tu música: Guardas tu colección en tu disco duro y la escuchas en todos tus dispositivos.
  • Escuchar en el celular sin gastar almacenamiento: Transmites tus canciones por Wi-Fi o internet en lugar de saturar la memoria de tu teléfono. 📱
  • Compatibilidad con apps móviles: Es compatible con la API de Subsonic, lo que te permite usar clientes como Symfonium o Subtracks en Android, y Amperfy en iOS.
  • Privacidad total: Tus hábitos de escucha son 100% privados y ningún servicio te va a eliminar canciones por derechos de autor. 🛡️
  • Transcodificación en tiempo real: Si tienes archivos FLAC pesados, puede convertirlos a MP3 al vuelo para no gastar tus datos móviles. 📶

🛠️ Guía de Instalación Nativa en CachyOS / Arch Linux

Si usas CachyOS, la forma más limpia de tener Navidrome es mediante una instalación nativa con systemd. A continuación tienes el paso a paso en terminal:

1. Instalar Navidrome desde AUR

Usa el helper paru (incluido por defecto en CachyOS) para compilar e instalar el paquete binario:

Bash

paru -S navidrome-bin

2. Crear carpetas y ajustar permisos

Creamos la carpeta donde Navidrome guardará su base de datos y le asignamos los permisos al usuario de sistema navidrome:

Bash

# Crear directorio de datos
sudo mkdir -p /var/lib/navidrome

# Asignar propietario al usuario de navidrome
sudo chown -R navidrome:navidrome /var/lib/navidrome

También debemos dar permisos de lectura para que Navidrome pueda acceder a la carpeta donde guardas tu música (ajusta si la tienes en tu /home):

Bash

chmod o+rx /home/$USER
chmod -R o+rX /home/$USER/Musica

3. Configurar el archivo navidrome.toml

Abre el archivo de configuración con el editor de texto nano:

Bash

sudo nano /etc/navidrome/navidrome.toml

Agrega o modifica los siguientes parámetros (asegúrate de cambiar tu_usuario por tu nombre de usuario real en CachyOS):

Ini, TOML

# Ruta a tu colección de música
MusicFolder = "/home/tu_usuario/Musica"

# Ruta donde se guardará la base de datos
DataFolder = "/var/lib/navidrome"

# Puerto de red predeterminado
Port = 4533

# Escaneo automático de nuevos archivos cada hora
ScanSchedule = "@every 1h"

# Idioma por defecto
DefaultLanguage = "es"

Tip: Guarda los cambios presionando Ctrl + O, confirma con Enter y sal con Ctrl + X.

4. Activar el servicio Systemd

Habilita el servicio para que Navidrome inicie automáticamente con tu sistema operativo:

Bash

sudo systemctl enable --now navidrome

Para verificar que todo está funcionando correctamente:

Bash

sudo systemctl status navidrome

🌐 Primer acceso y configuración inicial

  1. Abre tu navegador e ingresa a: http://localhost:4533
  2. La primera pantalla te pedirá crear una cuenta de administrador (asigna tu usuario y contraseña).
  3. ¡Listo! Navidrome comenzará a escanear tu carpeta de música de forma automática. 🚀

📌 Conclusión

Instalar Navidrome de forma nativa en CachyOS es sumamente rápido y eficiente. Con un consumo de recursos casi nulo y una integración perfecta con systemd, tendrás tu propia plataforma de música privada accesible desde cualquier dispositivo. ¡Toma el control de tus archivos digitales hoy mismo! 🎧🔥

📦 Cómo Instalar Nextcloud en Linux Mint con Snap (Guía Paso a Paso)

Entrada fija

¿Quieres tener tu propia nube privada en casa o en tu servidor local? Nextcloud es la solución perfecta para almacenar, sincronizar y compartir archivos sin depender de servicios externos como Google Drive o Dropbox.

En esta guía te enseñaré cómo instalar Nextcloud en Linux Mint utilizando Snap, el sistema de paquetes universales que hace que la instalación sea increíblemente sencilla.


📋 Requisitos Previos

  • Linux Mint instalado (cualquier versión reciente)
  • Conexión a internet
  • Acceso de administrador (sudo)
  • Una terminal abierta (Ctrl + Alt + T)

⚠️ Importante: Linux Mint y Snap

Por defecto, Linux Mint bloquea Snap por motivos de política. Así que primero debemos habilitarlo con unos sencillos pasos.


🚀 Pasos de Instalación

1️⃣ Eliminar el bloqueo de Snap

sudo rm /etc/apt/preferences.d/nosnap.pref

2️⃣ Actualizar los repositorios

sudo apt update

3️⃣ Instalar Snap

sudo apt install snapd

4️⃣ Instalar Nextcloud

sudo snap install nextcloud

¡Listo! La instalación tardará unos minutos. Nextcloud incluye automáticamente:

  • ✅ Servidor Apache
  • ✅ PHP 8.1
  • ✅ MySQL 8
  • ✅ Redis para caché

🌐 Acceder a Nextcloud

Una vez instalado, abre tu navegador y visita:

  • Localmente: http://localhost
  • Desde otros dispositivos en tu red: http://tu-ip-local

Para conocer tu IP local:

hostname -I

🔧 Si cambiaste de IP (por DHCP)

Es posible que necesites agregar tu IP como dominio confiable:

sudo nextcloud.occ config:system:set trusted_domains 1 --value=$(hostname -I | awk '{print $1}')

🔑 Crear Cuenta de Administrador

En tu primera visita a Nextcloud, se te pedirá que crees:

  • 👤 Nombre de usuario
  • 🔒 Contraseña de administrador

¡Guarda estos datos en un lugar seguro!


🛠️ Comandos Útiles para la Gestión

ComandoFunción
sudo snap start nextcloudIniciar Nextcloud
sudo snap stop nextcloudDetener Nextcloud
sudo snap restart nextcloudReiniciar Nextcloud
sudo snap services nextcloudVer estado del servicio
sudo snap logs nextcloudVer logs de errores
sudo snap set nextcloud ports.http=8080Cambiar puerto HTTP
sudo nextcloud.enable-httpsHabilitar HTTPS con Let’s Encrypt
sudo nextcloud.occ statusVer estado de Nextcloud

🔐 Restablecer Contraseña de Administrador

Si olvidaste la contraseña de admin:

sudo nextcloud.occ user:resetpassword admin

🖥️ Acceso a Almacenamiento Externo

Si necesitas usar discos externos montados en /media o /mnt:

sudo snap connect nextcloud:removable-media

🎯 Ventajas de Usar Snap para Nextcloud

  • ✅ Instalación sencilla en un solo comando
  • ✅ Actualizaciones automáticas sin complicaciones
  • ✅ Todo incluido (servidor web, base de datos, caché)
  • ✅ Fácil de gestionar con comandos Snap

❓ Solución de Problemas Comunes

No puedo acceder a Nextcloud

  1. Verifica que el servicio esté activo: sudo snap services nextcloud
  2. Comprueba los puertos disponibles: sudo ss -tulpn | grep snap.nextcloud
  3. Revisa los logs en busca de errores: sudo snap logs nextcloud | tail -20

El puerto 80 ya está en uso

Cambia el puerto HTTP:

sudo snap set nextcloud ports.http=8080

La IP cambia constantemente

Agrega el nuevo IP como dominio confiable (como se explicó arriba).


🎉 ¡Listo!

Ahora tienes tu propio servidor de nube privada funcionando en Linux Mint. Puedes:

  • 📁 Almacenar archivos
  • 📱 Sincronizar con el móvil (aplicación Nextcloud)
  • 👥 Compartir carpetas con otros usuarios
  • 🔄 Sincronizar calendarios y contactos

📚 Recursos Adicionales


¿Te ha sido útil esta guía? Déjame tu comentario y compártela con otros usuarios de Linux. ¡La privacidad y el control de tus datos es cosa de todos! 💪


🔖 Etiquetas

#Nextcloud #LinuxMint #Snap #NubePrivada #SelfHosting #Linux #Tecnología #Almacenamiento #SeguridadDigital

🚀 Implementa tu propio sistema de autorización de comprobantes SAP con CodeIgniter 4 y ODBC (Guía práctica + beneficios)

Entrada fija

📝 Por: julio 101290
Especialista en integraciones SAP – PHP – CodeIgniter

¿Cansado de los atascos en la aprobación de gastos, viáticos y facturas? ¿Los comprobantes se pierden en correos electrónicos o en papeles que nunca llegan? En este artículo te muestro cómo construí un módulo de autorización de comprobantes conectado directamente a SAP HANA usando CodeIgniter 4, ODBC y tecnologías web modernas. Además, te cuento los beneficios reales que obtendrás.


📌 Índice

  1. El problema de siempre: autorización manual
  2. La solución técnica: arquitectura limpia y directa
  3. Beneficios clave (✅ productividad, ✅ seguridad, ✅ movilidad)
  4. Código y componentes principales
  5. Lecciones aprendidas (y errores que evitar)
  6. Mejoras futuras y recomendaciones
  7. Conclusión: ¿por qué deberías implementarlo ya?

1. El problema de siempre: autorización manual 📄❌

Imaginemos el día a día:

  • Un empleado genera un comprobante de gasto en SAP (ej. CV__300000366).
  • El comprobante queda con estado U_Status = 2 (pendiente de autorización).
  • El autorizador recibe un correo, imprime, firma, escanea… o peor, usa un Excel compartido.
  • Contabilidad tarda días en enterarse de la aprobación.
  • No hay trazabilidad: ¿quién aprobó? ¿cuándo? ¿por qué?

🔴 Resultado: retrasos, errores, falta de control y equipos frustrados.


2. La solución técnica: arquitectura limpia y directa 🏗️

Decidí construir una interfaz web que se conecte directamente a las tablas de usuario de SAP (@QSYS_GLO_VOUC y @QSYS_GLO_VODE) usando ODBC. No necesitamos API intermedias ni modificar el núcleo de SAP.

🧱 Stack tecnológico elegido

Componente¿Por qué?
CodeIgniter 4Ligero, rápido, con excelente soporte para ODBC y JSON
ODBCConexión nativa a SAP HANA; sin controladores adicionales complicados
DataTablesTablas dinámicas con búsqueda, ordenamiento y paginación server-side
SweetAlert2Diálogos modernos para confirmar autorizaciones
Bootstrap 4Diseño responsivo (funciona en móvil, tableta y escritorio)
jQuery + AJAXComunicación asíncrona sin recargar la página

🔄 Flujo de trabajo

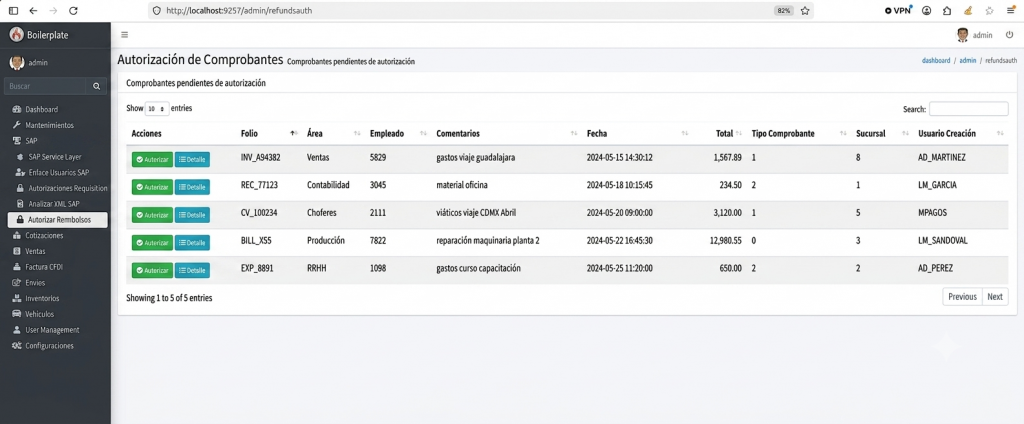
  1. El autorizador ingresa a la URL /admin/refundsauth.
  2. Se carga una DataTable con todos los comprobantes pendientes (U_Status = 2).
  3. Por cada fila, botones: Autorizar y Detalle.
  4. Al hacer clic en Detalle, se abre un modal responsivo que muestra las líneas del comprobante (tabla VODE).
  5. Al hacer clic en Autorizar, se confirma con SweetAlert y se envía una petición AJAX que actualiza U_Status = 4 directamente en SAP.
  6. La fila desaparece de la tabla y queda registrado en una bitácora local.

✅ Todo en tiempo real, sin papeles, sin correos, sin pérdidas.


3. Beneficios clave (✅ productividad, ✅ seguridad, ✅ movilidad)

🚀 Velocidad y productividad

  • De días a segundos: la autorización se hace con un clic.
  • El autorizador ve solo lo que le corresponde (filtros, búsqueda, orden).
  • Autorización masiva (se puede implementar fácilmente).

🔒 Trazabilidad y auditoría

  • Cada autorización queda registrada en la tabla log con usuario, fecha y detalles.
  • SAP conserva el histórico de U_Status (si se audita, se sabe cuándo cambió a 4).
  • Evita fraudes o aprobaciones sin conocimiento.

📱 Acceso móvil y responsivo

  • El diseño con Bootstrap y DataTables se adapta a cualquier dispositivo.
  • El modal de detalle tiene scroll horizontal (ideal para ver muchas columnas).
  • Los gerentes pueden aprobar gastos desde el móvil mientras viajan.

🧩 Integración sin fricción con SAP

  • No se necesita licencia adicional de Service Layer.
  • Las tablas @... son de usuario → se pueden leer/escribir con ODBC con permisos estándar.
  • La actualización es inmediata y consistente.

🛡️ Seguridad basada en roles

  • Cada usuario del sistema se vincula con un sapuser autorizador (tabla user_sap_link).
  • Solo los usuarios con el permiso adecuado pueden ver y autorizar.

💰 Bajo costo y rápido desarrollo

  • Solución implementada en menos de una semana.
  • Código 100% reutilizable y extensible.
  • No requiere comprar add‑ons caros de terceros.

4. Código y componentes principales (fragmentos clave) 🧩

Aquí te muestro las partes más importantes del controlador RefundsAuthController.php.

📡 Conexión ODBC y consulta de pendientes

$conn = odbc_connect($dataConect['nameODBC'], $dataConect['userODBC'], $dataConect['passwordODBC']);
$tableName = '"' . $dataConect['companyDB'] . '"."@QSYS_GLO_VOUC"';
$sql = "SELECT * FROM $tableName WHERE \"U_Status\" = 2 ORDER BY \"U_Date\" DESC";
$result = odbc_exec($conn, $sql);

✏️ Autorización (update directo)

$sqlUpdate = "UPDATE $tableName SET \"U_Status\" = 4 WHERE \"Code\" = $code";
odbc_exec($conn, $sqlUpdate);

📋 Detalle responsivo (modal con scroll)

$.ajax({
    url: base_url + '/admin/servicelayer/refundsauth/showVoucherDetails',
    data: JSON.stringify({ code: code }),
    success: function(resp) {
        var html = '<div class="table-responsive">' +
                   '<table class="table table-sm table-bordered">' +
                   // ... cabeceras y filas ...
                   '</table></div>';
        $('#modalVoucherDetailsBody').html(html);
    }
});

💡 El código completo lo puedes encontrar en mi repositorio de GitHub (link al final).


5. Lecciones aprendidas (y errores que evitar) 🧠

❌ Error 1: Nombres de tablas con @ sin comillas dobles

Solución: Siempre usar "DBNAME"."@TABLA". HANA es sensible a mayúsculas/minúsculas.

❌ Error 2: Usar LIMIT en ODBC sin ROW_NUMBER()

Solución: Emplear la función analítica ROW_NUMBER() OVER (ORDER BY ...) y filtrar por rn.

❌ Error 3: El modal se quedaba en “Cargando…”

Causa: Los IDs del contenedor en el modal no coincidían con los del JavaScript.
Solución: Sincronizar id="modalVoucherDetailsBody" en el HTML y en el JS.

❌ Error 4: La tabla no hacía scroll en móvil

Solución: Envolver la tabla en <div class="table-responsive"> y dar a la tabla un min-width: 700px mediante CSS.

❌ Error 5: Caracteres extraños en JSON

Solución: Aplicar utf8ize() recursivo a cada fila antes de enviarla.


6. Mejoras futuras y recomendaciones 🧪

Si quieres llevar el sistema al siguiente nivel, considera:

  • Autorización por lotes (seleccionar varios y aprobar con un botón).
  • Notificaciones por correo o WhatsApp cuando llegue un nuevo comprobante.
  • Rechazo con motivo y notificación al empleado.
  • Dashboard de indicadores (tiempo promedio de autorización, montos aprobados, etc.).
  • Firma digital para cumplir normativas.
  • Integración con SAP Business Workflow (si la empresa lo requiere).

7. Conclusión: ¿por qué deberías implementarlo ya? 🎯

La combinación CodeIgniter 4 + ODBC + DataTables permite construir en pocos días un sistema de autorización de comprobantes que:

  • Reduce drásticamente los tiempos de espera.
  • Elimina el papeleo y los correos perdidos.
  • Brinda movilidad a los aprobadores.
  • Aporta transparencia y auditoría.
  • Se integra de forma nativa con SAP sin costes adicionales.

¿Tu empresa sigue aprobando gastos con firmas manuales y hojas de cálculo?
Es hora de dar el salto a la automatización web. Yo ya lo hice para varios clientes, y los resultados han sido increíbles: +80% de agilidad, 0 errores de registro y aprobaciones desde el móvil.


🔗 Recursos adicionales


📢 Comparte este artículo si te ha resultado útil
♻️ ¿Conoces a alguien que todavía autoriza comprobantes en papel? Etiquétalo en los comentarios.

#SAP #CodeIgniter #ODBC #AutorizaciónDeGastos #PHP #DesarrolloWeb #TransformaciónDigital

🔥 Error Fatal en CodeIgniter 4: Undefined property Config\Format::$jsonEncodeDepth

Entrada fija

Si después de actualizar CodeIgniter 4 te apareció un error como este:

PHP Fatal error:
Undefined property: Config\Format::$jsonEncodeDepth

y el stack trace apunta a:

system/Format/JSONFormatter.php

la causa casi siempre es la misma:
tu archivo app/Config/Format.php quedó desactualizado después de actualizar el framework.


📌 ¿Por qué sucede?

En versiones recientes de CodeIgniter 4 se agregaron nuevas propiedades para el manejo de JSON.

El problema ocurre cuando:

  • actualizas vendor/codeigniter4/framework
  • pero conservas un archivo viejo en:
app/Config/Format.php

Entonces el framework intenta acceder a propiedades que no existen.


⚠️ Error completo

Undefined property: Config\Format::$jsonEncodeDepth

Relacionado con:

CodeIgniter\Format\JSONFormatter.php

✅ Solución

Abrir:

app/Config/Format.php

y agregar las propiedades faltantes dentro de la clase Format.


✅ Configuración corregida

&lt;?php

namespace Config;

use CodeIgniter\Config\BaseConfig;

class Format extends BaseConfig
{
    public array $supportedResponseFormats = [
        'application/json',
        'application/xml',
        'text/xml',
    ];

    public string $formatter = 'application/json';

    public array $formatters = [
        'application/json' =&gt; \CodeIgniter\Format\JSONFormatter::class,
        'application/xml'  =&gt; \CodeIgniter\Format\XMLFormatter::class,
        'text/xml'         =&gt; \CodeIgniter\Format\XMLFormatter::class,
    ];

    public int $jsonEncodeOptions =
        JSON_UNESCAPED_UNICODE | JSON_UNESCAPED_SLASHES;

    public bool $jsonDecodeAssociative = true;

    public int $jsonEncodeDepth = 512;

    public int $jsonDecodeDepth = 512;
}

🧹 Limpiar caché

Después de guardar cambios ejecutar:

php spark cache:clear

🔄 Reiniciar servicios

Si usas Apache, PHP-FPM o Docker:

sudo systemctl restart apache2

o el servicio correspondiente.


💡 Recomendación importante

Cada vez que actualices CodeIgniter 4:

  • ✅ compara tus archivos en:
app/Config/

contra los originales del framework:

vendor/codeigniter4/framework/app/Config/

porque muchas veces nuevas versiones agregan propiedades nuevas y los proyectos antiguos conservan configuraciones incompatibles.


🚀 Resultado

Después de agregar:

public int $jsonEncodeDepth = 512;

el error desaparece y las respuestas JSON vuelven a funcionar correctamente.


#CodeIgniter #PHP #CodeIgniter4 #PostgreSQL #MariaDB #Backend #WebDevelopment #Programacion #PHPDeveloper #OpenSource

Cómo instalar Openfire con Docker en Ubuntu y solucionar el error de “no carga la consola web”

Entrada fija

Guía definitiva paso a paso para tener tu servidor XMPP funcionando y accesible desde toda la red.

Introducción

Openfire es un potente servidor de mensajería XMPP (Jabber) muy utilizado en entornos empresariales y proyectos de comunicación interna. Instalarlo con Docker es rápido y limpio, pero es común encontrarse con un problema: la consola web no carga cuando intentas acceder desde otra computadora, aunque desde el propio servidor funcione con localhost.

En este artículo te mostraré cómo instalar Openfire usando Docker en Ubuntu, y cómo solucionar ese molesto error de conectividad, que normalmente está relacionado con el firewall (UFW) y la interfaz de escucha del contenedor.

Requisitos previos

  • Un servidor o máquina virtual con Ubuntu 20.04 / 22.04 / 24.04.
  • Docker y Docker Compose instalados (te muestro cómo).
  • Acceso root o usuario con sudo.
  • Puertos necesarios: 9090 (web admin), 9091 (admin seguro), 5222 (clientes), 5269 (federación).

Paso 1: Instalar Docker en Ubuntu

Si aún no tienes Docker, ejecuta:

sudo apt update
sudo apt install -y apt-transport-https ca-certificates curl software-properties-common
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /usr/share/keyrings/docker-archive-keyring.gpg
echo "deb [arch=$(dpkg --print-architecture) signed-by=/usr/share/keyrings/docker-archive-keyring.gpg] https://download.docker.com/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
sudo apt update
sudo apt install -y docker-ce
sudo systemctl enable docker
sudo usermod -aG docker $USER   # (opcional, para no usar sudo)

Verifica: docker --version

Paso 2: Crear volúmenes persistentes

Los datos y logs de Openfire deben guardarse fuera del contenedor:

docker volume create openfire_data
docker volume create openfire_logs

Paso 3: Ejecutar Openfire con red bridge (RECOMENDADO)

No uses --network host si quieres acceder desde otras máquinas, a menos que sepas configurar el firewall. Usa mapeo de puertos explícito:

docker run -d \
  --name openfire \
  --restart unless-stopped \
  -p 9090:9090 -p 9091:9091 \
  -p 5222:5222 -p 5223:5223 -p 5269:5269 \
  -v openfire_data:/var/lib/openfire \
  -v openfire_logs:/var/log/openfire \
  ghcr.io/igniterealtime/openfire:latest

Verifica que esté corriendo:

docker ps

Paso 4: El problema típico – no accedo desde otra PC

Ejecutas curl http://localhost:9090 en el servidor y obtienes respuesta, pero desde tu ordenador personal http://IP_DEL_SERVIDOR:9090 no carga. ¿Por qué?

  • Causa principal: El firewall de Ubuntu (UFW) bloquea el tráfico externo hacia Docker.
  • Causa secundaria: Openfire podría estar escuchando solo en 127.0.0.1 dentro del contenedor.

Solución definitiva (UFW + Docker)

Instala el script ufw-docker que hace que Docker respete las reglas de UFW:

sudo wget -O /usr/local/bin/ufw-docker https://raw.githubusercontent.com/chaifeng/ufw-docker/master/ufw-docker
sudo chmod +x /usr/local/bin/ufw-docker
sudo ufw-docker install
sudo ufw allow 9090/tcp
sudo ufw allow 9091/tcp

Si tenías UFW desactivado, actívalo:

sudo ufw enable

¡Importante! Después de esto, reinicia Docker para aplicar los cambios de iptables:

sudo systemctl restart docker
docker start openfire

Ahora prueba de nuevo desde tu navegador: http://IP_DEL_SERVIDOR:9090 debería mostrar el asistente de configuración de Openfire.

Paso 5: Configuración inicial – poner la IP como dominio

Cuando accedas por primera vez, el asistente web te pedirá:

  • Idioma: Elige el tuyo.
  • Dominio del servidor XMPP: Aquí debes escribir la IP pública o privada de tu servidor (ej: 192.168.1.100). Si tienes un dominio real, úsalo. Esto es lo que llamamos “poner la IP en el dominio”.
  • Puertos de administración: Déjalos en 9090 y 9091.
  • Base de datos: Elige la embebida H2 (o configura una externa).
  • Contraseña de administrador: Elige una segura.

Completa los pasos y tendrás tu servidor Openfire listo.

Paso 6: Verificación final

Desde otra máquina en la misma red:

telnet IP_DEL_SERVIDOR 9090

O simplemente abre el navegador. Si todo está bien, verás la pantalla de login de la consola de administración.

Solución alternativa (si el problema persiste)

Si después de lo anterior sigues sin acceso, edita la configuración de Openfire para forzar la escucha en 0.0.0.0:

docker exec -it openfire bash
apt update && apt install -y nano
nano /var/lib/openfire/conf/openfire.xml

Dentro de <jive>, agrega o modifica:

<adminConsole>
    <interface>0.0.0.0</interface>
    <port>9090</port>
    <securePort>9091</securePort>
</adminConsole>

Guarda (Ctrl+O), sal (Ctrl+X) y reinicia el contenedor:

exit
docker restart openfire

Conclusión

Instalar Openfire con Docker es sencillo, pero el error de “no carga la consola web desde otra PC” es muy común debido a la interacción entre Docker y UFW. Con el script ufw-docker y usando la red bridge con mapeo de puertos, el problema se resuelve de raíz. Ahora ya puedes disfrutar de tu propio servidor XMPP accesible desde toda tu red local.

¿Te ha servido? Déjame un comentario y comparte este tutorial con otros administradores.

🎧 Cómo usar Ardour con batería electrónica en Linux Mint (sin errores y con sonido PRO)

Entrada fija

Si estás usando Ardour en Linux Mint con una interfaz Behringer y una batería electrónica por USB, seguramente ya te topaste con problemas como:

  • ❌ No se escucha nada
  • ❌ La batería sí detecta pero no suena
  • ❌ Error: JACK HALTED
  • ❌ El audio se “desconecta” solo

Aquí tienes la guía completa para dejar todo funcionando como estudio profesional 🔥


🧠 Entendiendo el sistema de audio en Linux

En Linux Mint moderno usamos PipeWire.

Este sistema reemplaza:

  • PulseAudio (audio normal)
  • JACK (audio profesional)

👉 Resultado: puedes usar Ardour con baja latencia SIN configuraciones complicadas.


🔌 Paso 1: conectar correctamente tu interfaz

  1. Conecta tu interfaz Behringer
  2. Conecta tu batería electrónica por USB
  3. Verifica que Linux la detecta:
aconnect -l

🎛️ Paso 2: abrir Ardour correctamente

pw-jack ardour

👉 Esto asegura compatibilidad con JACK dentro de PipeWire.


🔊 Paso 3: configurar la salida de audio (MUY IMPORTANTE)

pactl list short sinks

Busca algo como:

alsa_output.usb-BEHRINGER_UMC202HD...

⚠️ Error común

iec958-stereo

👉 Eso es salida DIGITAL ❌
👉 No se escucha en audífonos

✅ Solución: usar modo PRO

pactl set-card-profile alsa_card.usb-BEHRINGER_UMC202HD_192k_12345678-00.2 pro-audio
pactl set-default-sink alsa_output.usb-BEHRINGER_UMC202HD_192k_12345678-00.2.pro-output-0

💤 Paso 4: evitar que el audio se “apague”

mkdir -p ~/.config/pipewire/pipewire.conf.d
nano ~/.config/pipewire/pipewire.conf.d/disable-suspend.conf

Agrega:

context.properties = {
    session.suspend-timeout-seconds = 0
}
systemctl --user restart pipewire pipewire-pulse

🥁 Paso 5: configurar batería MIDI

aconnect -l

En Ardour:

  • Crea pista MIDI
  • Selecciona tu batería como input
  • Inserta MT Power Drum Kit 2
  • Activa Record y Monitor

🔊 Paso 6: ruteo de audio

En Ardour:

Window → Audio Connections

  • Pista → Master
  • Master → playback 1 y 2 (Behringer)

❌ Error común: JACK HALTED

JACK HALTED: JACK server has been closed

🔥 Causas:

  • Desconectar la interfaz
  • Cambiar configuración de audio
  • PipeWire reinicia

✅ Solución:

systemctl --user restart pipewire pipewire-pulse
pw-jack ardour

🧠 Regla de oro

Nunca conectes o desconectes la interfaz con Ardour abierto


🎚️ Bonus: editar batería MIDI

  • Mover golpes
  • Borrar errores
  • Ajustar velocidad (velocity)
  • Cuantizar

Doble clic en el clip MIDI para editar.


🥁 Bonus PRO: separar batería por pistas

  • Kick
  • Snare
  • Hi-hat
  • Toms

👉 Mezcla como en estudio real.


🚀 Resultado final

  • ✔ Audio estable
  • ✔ Baja latencia
  • ✔ Batería funcionando
  • ✔ Plugins activos
  • ✔ Flujo profesional

🎯 Recomendación final

Prueba también:

  • DrumGizmo (nativo Linux, nivel pro)
  • Plugins con Wine + Yabridge

💬 Si quieres, puedo ayudarte a optimizar latencia, mezcla o mapeo de tu batería.

Página 1 de 143

Creado con WordPress & Tema de Anders Norén