Herramientas Informaticas

Etiqueta: Python

📲 Cómo convertir un chat de WhatsApp (con fotos y audios) en un PDF para crear tutoriales con IA 🤖✨

Entrada fija

¿Alguna vez has explicado un proceso completo por WhatsApp enviando capturas de pantalla, notas de voz y mensajes de texto… y pensaste: “Ojalá pudiera convertir esto en un tutorial sin tener que redactarlo todo desde cero”? 🤔💡

Cuando exportas un chat con archivos multimedia, WhatsApp te entrega un archivo .zip desordenado: un archivo .txt por un lado, carpetas llenas de fotos sueltas por otro, y audios en formato .opus que son imposibles de leer en un documento.

¡Hoy vamos a solucionar eso! 🚀 Veremos cómo transformar ese .zip en un PDF interactivo y visual con:

  • 📸 Imágenes incrustadas en el lugar exacto donde se enviaron.
  • 🎙️ Audios transcritos automáticamente a texto usando Inteligencia Artificial local.
  • 📄 Diseño limpio estilo WhatsApp listo para que una IA (como Gemini o ChatGPT) lo lea y redacte un tutorial profesional en segundos.

🛠️ ¿Qué necesitamos?

Solo necesitas tu computadora (preferiblemente con Linux o terminal) y unas pocas herramientas gratuitas:

  1. Python 3 instalado.
  2. FFmpeg (para procesar los archivos de audio).
  3. faster-whisper (un modelo de IA local ultrarrápido que convierte voz a texto sin enviar tus audios a internet).

🚀 Paso 1: Preparar el entorno

Para evitar conflictos de librerías en sistemas modernos, abrimos la terminal y preparamos nuestro entorno virtual en un par de comandos:

Bash

# 1. Instalar herramientas base
sudo apt update && sudo apt install -y ffmpeg python3-pip python3-venv

# 2. Crear y activar un entorno virtual
python3 -m venv env_whatsapp
source env_whatsapp/bin/activate

# 3. Instalar la IA de transcripción
pip install faster-whisper

🔒 Dato clave de privacidad: faster-whisper corre 100% en tu procesador. Tus conversaciones privadas nunca salen de tu máquina.

🐍 Paso 2: El script mágico

Creamos un archivo llamado exportar_chat_completo.py y pegamos un script que haga tres tareas automáticas:

  1. Leer el archivo .txt y armar las burbujas de diálogo.
  2. Detectar las imágenes .jpg o .png y convertirlas a Base64 para que queden incrustadas directamente dentro del HTML.
  3. Detectar las notas de voz .opus, transcribirlas con Whisper e insertar el texto dentro de la conversación.

Código del script:

Python

#!/usr/bin/env python3
import sys, os, re, zipfile, base64, html, tempfile
from faster_whisper import WhisperModel

if len(sys.argv) < 2:
    print("Uso: python exportar_chat_completo.py <archivo.zip>")
    sys.exit(1)

zip_path = sys.argv[1]
output_html = "chat_completo.html"

print("🧠 Cargando modelo de transcripción...")
whisper_model = WhisperModel("base", device="cpu", compute_type="int8")

with zipfile.ZipFile(zip_path, 'r') as z:
    file_list = z.namelist()
    txt_name = [f for f in file_list if f.endswith('.txt')][0]
    chat_content = z.read(txt_name).decode('utf-8-sig', errors='replace')
    
    # Regex para extraer mensajes
    msg_pattern = re.compile(r"^\[?(\d{1,2}/\d{1,2}/\d{2,4},?\s+\d{1,2}:\d{2}(?::\d{2})?(?:\s+[ap]\.?\s?m\.?)?)\]?\s*(?:-\s*)?([^:]+):\s*(.*)$", re.IGNORECASE)
    
    messages, senders, current_msg = [], set(), None
    for line in chat_content.splitlines():
        match = msg_pattern.match(line)
        if match:
            if current_msg: messages.append(current_msg)
            dt, sender, text = match.groups()
            senders.add(sender.strip())
            current_msg = {'time': dt.strip(), 'sender': sender.strip(), 'text': text.strip()}
        elif current_msg:
            current_msg['text'] += "\n" + line
    if current_msg: messages.append(current_msg)

    primary_sender = list(senders)[0] if senders else ""
    img_pattern = re.compile(r"([\w\-\.]+\.(?:jpg|jpeg|png|webp))", re.IGNORECASE)
    audio_pattern = re.compile(r"([\w\-\.]+\.(?:opus|m4a|mp3|ogg))", re.IGNORECASE)
    
    bubbles = []
    print(f"📦 Procesando {len(messages)} mensajes...")

    for idx, msg in enumerate(messages, start=1):
        is_me = (msg['sender'] == primary_sender)
        bubble_cls = "bubble outgoing" if is_me else "bubble incoming"
        raw_text = msg['text']

        # Incrustar fotos en Base64
        imgs_html = ""
        for img_name in img_pattern.findall(raw_text):
            target = [f for f in file_list if f.endswith(img_name)]
            if target:
                data = base64.b64encode(z.read(target[0])).decode('utf-8')
                imgs_html += f'<div class="img-box"><img src="data:image/jpeg;base64,{data}" /></div>'

        # Transcribir audios con IA
        audios_html = ""
        for aud_name in audio_pattern.findall(raw_text):
            target = [f for f in file_list if f.endswith(aud_name)]
            if target:
                print(f"🎙️ Transcribiendo audio: {aud_name}...")
                with tempfile.NamedTemporaryFile(suffix=os.path.splitext(aud_name)[1], delete=False) as tmp:
                    tmp.write(z.read(target[0]))
                    tmp_p = tmp.name
                try:
                    segs, _ = whisper_model.transcribe(tmp_p, language="es")
                    txt = " ".join([s.text for s in segs]).strip() or "(Audio sin voz clara)"
                except:
                    txt = "(Error en transcripción)"
                finally:
                    if os.path.exists(tmp_p): os.remove(tmp_p)
                audios_html += f'<div class="audio-box"><strong>🎙️ Transcripción:</strong> "{html.escape(txt)}"</div>'

        clean_text = html.escape(raw_text).replace('\n', '<br>')
        bubbles.append(f"""
        <div class="{bubble_cls}">
            <div class="sender">{html.escape(msg['sender'])}</div>
            {imgs_html}
            {audios_html}
            <div class="txt">{clean_text}</div>
            <div class="time">{html.escape(msg['time'])}</div>
        </div>
        """)

# Estilos CSS listos para imprimir a PDF
html_doc = f"""<!DOCTYPE html><html><head><meta charset="utf-8">
<style>
  body {{ background: #efeae2; font-family: sans-serif; display: flex; justify-content: center; padding: 20px; }}
  .chat {{ width: 100%; max-width: 780px; display: flex; flex-direction: column; gap: 8px; }}
  .bubble {{ max-width: 75%; padding: 8px 12px; border-radius: 8px; font-size: 14px; display: flex; flex-direction: column; }}
  .incoming {{ background: #fff; align-self: flex-start; }}
  .outgoing {{ background: #d9fdd3; align-self: flex-end; }}
  .sender {{ font-weight: bold; font-size: 11px; color: #128c7e; margin-bottom: 3px; }}
  .outgoing .sender {{ display: none; }}
  .img-box img {{ max-width: 100%; border-radius: 6px; margin: 5px 0; }}
  .audio-box {{ background: rgba(0,0,0,0.05); border-left: 3px solid #00a884; padding: 6px 10px; margin: 5px 0; font-style: italic; }}
  .time {{ font-size: 10px; color: #667781; align-self: flex-end; margin-top: 4px; }}
  @media print {{ body {{ background: white; }} .bubble {{ page-break-inside: avoid; border: 1px solid #ccc; }} }}
</style></head><body><div class="chat">{''.join(bubbles)}</div></body></html>"""

with open(output_html, "w", encoding="utf-8") as f:
    f.write(html_doc)
print(f"🎉 ¡Listo! Archivo '{output_html}' generado con éxito.")

⚡ Paso 3: Ejecutar y exportar a PDF

  1. Corre el script con tu chat:Bashpython exportar_chat_completo.py "MiChatExportado.zip"
  2. Abre el archivo generado (chat_completo.html) en tu navegador favorito.
  3. Presiona Ctrl + P (Imprimir).
  4. Elige Guardar como PDF y asegúrate de marcar la casilla “Gráficos de fondo” para que conserve los colores originales.

🧠 Paso 4: La magia de la IA para armar tu tutorial

¡Ahora viene lo mejor! Sube tu nuevo archivo PDF a una IA multimodal y dale esta instrucción:

“Actúa como redactor técnico y diseñador instruccional. Analiza este documento PDF que contiene capturas, mensajes y transcripciones de notas de voz. Descarta las charlas casuales y crea un tutorial paso a paso numerado, explicando cada acción y detallando qué se observa en cada captura de pantalla para guiar al usuario.”

En cuestión de segundos tendrás un manual técnico o una guía de uso impecable, estructurada y sin haber pasado horas transcribiendo audios ni acomodando capturas en Word. 🎯👏

¿Qué te parece este flujo de trabajo? ¡Pruébalo con tu próxima explicación técnica y cuéntanos en los comentarios cómo te fue! 👇💬

Cómo crear un Asistente de IA para SAP Business One en Spark / Openfire con RAG local y Ollama

Entrada fija

¿Cuántas horas a la semana invierte el área de soporte o consultoría en responder las mismas preguntas sobre rutas de menús, códigos de error, tablas de base de datos o procedimientos de SAP Business One?

Para solucionar esto sin comprometer la privacidad corporativa ni pagar costosas suscripciones de APIs en la nube, implementamos un asistente de soporte 100% local. El bot se conecta directamente como un usuario al servidor corporativo de mensajería instantánea Openfire / Spark, lee manuales en PDF y Word (.docx) mediante RAG (Retrieval-Augmented Generation), extrae texto de diagramas o capturas de pantalla con OCR, muestra el indicador animado de «Escribiendo…» y entrega respuestas precisas con enlaces directos a las capturas del sistema.

A continuación, te mostramos la arquitectura y el paso a paso para construirlo en Ubuntu Server.

1. Arquitectura de la Solución

El sistema opera completamente dentro de la red corporativa bajo el siguiente flujo:

  1. Indexación previa (Off-line): Un script en Python escanea la carpeta de manuales (.pdf y .docx), extrae texto estructurado, tablas y aplica OCR con Tesseract a capturas de pantalla. El texto se vectoriza con nomic-embed-text y se guarda en ChromaDB.
  2. Servidor HTTP de imágenes: Las capturas de pantalla extraídas quedan disponibles en un microservidor web local para que los usuarios puedan abrirlas en alta resolución con un solo clic.
  3. Bot XMPP (slixmpp): Se autentica en Openfire como un usuario de soporte (ej. asistente@xmpp.empresa.local).
  4. Respuesta contextualizada (LLM): Al recibir un mensaje, avisa a Spark que está escribiendo (XEP-0085), recupera los fragmentos del manual más relevantes y consulta a Qwen 2.5:7b acelerado por GPU local.
  5. Auditoría (SQLite): Cada consulta, tipo de respuesta (manual interno vs. estándar de SAP) y usuario queda registrada para auditoría y mejora continua de la documentación.

2. Preparación del Servidor y Dependencias

En tu máquina con Ubuntu Server, instala las herramientas del sistema, el motor de OCR y las librerías de Python necesarias:

Bash

# 1. Herramientas del sistema y OCR en español
sudo apt update && sudo apt install -y tesseract-ocr tesseract-ocr-spa libgl1 python3-pip sqlite3

# 2. Librerías de Python requeridas
pip install --break-system-packages slixmpp chromadb pymupdf python-docx pytesseract pillow ollama

# 3. Modelos locales con Ollama
ollama pull nomic-embed-text
ollama pull qwen2.5:7b

# 4. Estructura de directorios
mkdir -p ~/sap_bot/manuales
mkdir -p ~/sap_bot/static_imgs
cd ~/sap_bot

Nota: Coloca tus guías operativas, diccionarios de datos y manuales en formato .pdf o .docx dentro de la carpeta ~/sap_bot/manuales/.

3. Servidor Web Local para Capturas de Pantalla

Para que el bot pueda adjuntar enlaces a las capturas de los manuales y los usuarios de Spark puedan verlas en el navegador sin fricción, creamos un servicio ligero con Python:

Bash

sudo tee /etc/systemd/system/sap-imgs.service << EOF
[Unit]
Description=Servidor HTTP para Capturas de Manuales SAP
After=network.target

[Service]
Type=simple
User=$USER
WorkingDirectory=$HOME/sap_bot/static_imgs
ExecStart=/usr/bin/python3 -m http.server 8080 --bind 0.0.0.0
Restart=always

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable --now sap-imgs.service

4. Script de Indexación Inteligente con OCR (indexar_manuales.py)

Este script se encarga de analizar los manuales, separar el texto en fragmentos con solapamiento (chunking), extraer tablas, guardar capturas de pantalla y procesar imágenes que contengan texto con Tesseract.

Crea el archivo ~/sap_bot/indexar_manuales.py:

Python

#!/usr/bin/env python3
"""
Indexador de Documentación SAP B1 (PDF y DOCX) con OCR y ChromaDB.
"""
import os
import io
import re
import fitz  # PyMuPDF
import docx  # python-docx
import pytesseract
from PIL import Image
import chromadb
import ollama

BASE_DIR = os.path.dirname(os.path.abspath(__file__))
CARPETA_MANUALES = os.path.join(BASE_DIR, "manuales")
CARPETA_IMGS = os.path.join(BASE_DIR, "static_imgs")
DB_PATH = os.path.join(BASE_DIR, "chroma_sap_db")

CHUNK_SIZE = 900
CHUNK_OVERLAP = 150
MODELO_EMBED = "nomic-embed-text"

def limpiar_nombre(nombre: str) -> str:
    return re.sub(r'[^a-zA-Z0-9_\-\.]', '_', nombre)

def fragmentar_texto(texto: str, tamano: int = CHUNK_SIZE, solapamiento: int = CHUNK_OVERLAP) -> list[str]:
    fragmentos = []
    inicio = 0
    while inicio < len(texto):
        fin = inicio + tamano
        fragmentos.append(texto[inicio:fin])
        inicio += tamano - solapamiento
    return fragmentos

def obtener_vector(texto: str) -> list[float]:
    res = ollama.embeddings(model=MODELO_EMBED, prompt=texto)
    return res["embedding"]

def procesar_pdf(ruta_pdf: str, archivo: str, coleccion, contador_inicio: int) -> int:
    doc = fitz.open(ruta_pdf)
    contador = contador_inicio
    nombre_base = limpiar_nombre(os.path.splitext(archivo)[0])

    for num_pagina in range(len(doc)):
        pagina = doc[num_pagina]
        texto = pagina.get_text().strip()
        imagenes = pagina.get_images(full=True)
        imagenes_guardadas = []

        if imagenes:
            for idx_img, img_info in enumerate(imagenes):
                try:
                    xref = img_info[0]
                    img_dict = doc.extract_image(xref)
                    img_pil = Image.open(io.BytesIO(img_dict["image"]))
                    
                    # Filtrar viñetas o elementos menores a 120px
                    if img_pil.width > 120 and img_pil.height > 120:
                        nombre_img = f"{nombre_base}_p{num_pagina + 1}_img{idx_img}.png"
                        img_pil.save(os.path.join(CARPETA_IMGS, nombre_img))
                        imagenes_guardadas.append(nombre_img)

                        if len(texto) < 120:
                            ocr = pytesseract.image_to_string(img_pil, lang="spa")
                            if ocr.strip():
                                texto += f"\n[Texto en captura {nombre_img}]:\n" + ocr.strip()
                except Exception:
                    continue

        if len(texto.strip()) < 30 and not imagenes_guardadas:
            continue

        bloques = fragmentar_texto(texto)
        str_imgs = ",".join(imagenes_guardadas)

        for idx, bloque in enumerate(bloques):
            try:
                vector = obtener_vector(bloque)
                chunk_id = f"{archivo}_p{num_pagina + 1}_b{idx}_{contador}"
                coleccion.add(
                    ids=[chunk_id],
                    embeddings=[vector],
                    documents=[bloque],
                    metadatas=[{
                        "archivo": archivo,
                        "pagina": str(num_pagina + 1),
                        "imagenes": str_imgs
                    }]
                )
                contador += 1
            except Exception as err:
                print(f"[-] Error en vector: {err}")

    return contador

def procesar_docx(ruta_docx: str, archivo: str, coleccion, contador_inicio: int) -> int:
    doc = docx.Document(ruta_docx)
    contador = contador_inicio
    nombre_base = limpiar_nombre(os.path.splitext(archivo)[0])
    contenido = []
    imagenes_guardadas = []

    for p in doc.paragraphs:
        if p.text.strip():
            contenido.append(p.text.strip())

    for t_idx, tabla in enumerate(doc.tables):
        filas = [" | ".join(c.text.strip() for c in f.cells if c.text.strip()) for f in tabla.rows]
        if filas:
            contenido.append(f"\n[Tabla {t_idx + 1}]:\n" + "\n".join(filas))

    idx_img = 0
    for part in doc.part.related_parts.values():
        if getattr(part, "content_type", "").startswith("image/"):
            try:
                img_pil = Image.open(io.BytesIO(part.blob))
                if img_pil.width > 120 and img_pil.height > 120:
                    nombre_img = f"{nombre_base}_word_img{idx_img}.png"
                    img_pil.save(os.path.join(CARPETA_IMGS, nombre_img))
                    imagenes_guardadas.append(nombre_img)
                    idx_img += 1

                    ocr = pytesseract.image_to_string(img_pil, lang="spa")
                    if ocr.strip():
                        contenido.append(f"\n[Texto en captura {nombre_img}]:\n" + ocr.strip())
            except Exception:
                continue

    texto_total = "\n\n".join(contenido).strip()
    if len(texto_total) < 30 and not imagenes_guardadas:
        return contador

    bloques = fragmentar_texto(texto_total)
    str_imgs = ",".join(imagenes_guardadas)

    for idx, bloque in enumerate(bloques):
        try:
            vector = obtener_vector(bloque)
            chunk_id = f"{archivo}_sec_{idx}_{contador}"
            coleccion.add(
                ids=[chunk_id],
                embeddings=[vector],
                documents=[bloque],
                metadatas=[{
                    "archivo": archivo,
                    "pagina": f"Sección {idx + 1}",
                    "imagenes": str_imgs
                }]
            )
            contador += 1
        except Exception as err:
            print(f"[-] Error en vector Word: {err}")

    return contador

def ejecutar_indexacion():
    os.makedirs(CARPETA_MANUALES, exist_ok=True)
    os.makedirs(CARPETA_IMGS, exist_ok=True)
    client = chromadb.PersistentClient(path=DB_PATH)

    formatos = (".pdf", ".docx")
    archivos = [f for f in os.listdir(CARPETA_MANUALES) if f.lower().endswith(formatos)]

    if not archivos:
        print("[!] No hay archivos para indexar. Creando base de datos vacía...")
        client.get_or_create_collection(name="manuales_sap")
        return

    try:
        client.delete_collection(name="manuales_sap")
    except Exception:
        pass
    coleccion = client.create_collection(name="manuales_sap")

    contador = 0
    for archivo in archivos:
        ruta = os.path.join(CARPETA_MANUALES, archivo)
        print(f"[+] Indexando: {archivo}")
        if archivo.lower().endswith(".pdf"):
            contador = procesar_pdf(ruta, archivo, coleccion, contador)
        elif archivo.lower().endswith(".docx"):
            contador = procesar_docx(ruta, archivo, coleccion, contador)

    print(f"\n[✓] Indexación finalizada. Total de fragmentos: {contador}")

if __name__ == "__main__":
    ejecutar_indexacion()

5. El Bot XMPP para Spark (bot_spark.py)

Este script se encarga de:

  1. Conectarse de forma asíncrona al servidor Openfire.
  2. Emitir el paquete XEP-0085 para mostrar «Escribiendo…» de inmediato en Spark.
  3. Consultar la base vectorial sin bloquear el hilo principal.
  4. Generar respuestas en GPU y registrar la interacción en SQLite.

Crea el archivo ~/sap_bot/bot_spark.py:

Python

#!/usr/bin/env python3
"""
Bot Asistente SAP B1 para Spark (XMPP + Ollama + ChromaDB + SQLite).
"""
import os
import ssl
import asyncio
import sqlite3
from datetime import datetime
import slixmpp
import chromadb
import ollama

# ================= CONFIGURACIÓN DEL SERVIDOR =================
BASE_DIR = os.path.dirname(os.path.abspath(__file__))
DB_PATH = os.path.join(BASE_DIR, "chroma_sap_db")
DB_LOGS_PATH = os.path.join(BASE_DIR, "historial_conversaciones.db")

# Datos genéricos de conexión Openfire / Spark
JID_BOT = "asistente_sap@xmpp.empresa.local"
PASSWORD_BOT = "PasswordSeguro123"
HOST_SERVIDOR = "192.168.1.50"
PUERTO_XMPP = 5222

# Enlace base para servir las capturas de pantalla
URL_BASE_IMGS = f"http://{HOST_SERVIDOR}:8080"

MODELO_LLM = "qwen2.5:7b"
MODELO_EMBED = "nomic-embed-text"
# ==============================================================

def inicializar_bd_logs():
    with sqlite3.connect(DB_LOGS_PATH) as conn:
        cursor = conn.cursor()
        cursor.execute("""
            CREATE TABLE IF NOT EXISTS conversaciones (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                fecha_hora TEXT,
                usuario_spark TEXT,
                pregunta TEXT,
                tipo_fuente TEXT,
                respuesta TEXT
            )
        """)
        conn.commit()

def registrar_log(usuario: str, pregunta: str, tipo_fuente: str, respuesta: str):
    try:
        with sqlite3.connect(DB_LOGS_PATH) as conn:
            cursor = conn.cursor()
            cursor.execute("""
                INSERT INTO conversaciones (fecha_hora, usuario_spark, pregunta, tipo_fuente, respuesta)
                VALUES (?, ?, ?, ?, ?)
            """, (
                datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
                usuario,
                pregunta,
                tipo_fuente,
                respuesta
            ))
            conn.commit()
    except Exception as err:
        print(f"[-] Error en log SQLite: {err}")

class SparkAIBot(slixmpp.ClientXMPP):
    def __init__(self, jid: str, password: str):
        super().__init__(jid, password)
        self.add_event_handler("session_start", self.on_start)
        self.add_event_handler("message", self.on_message)

        # Aceptar certificados locales/autofirmados
        self.ssl_context = ssl.create_default_context()
        self.ssl_context.check_hostname = False
        self.ssl_context.verify_mode = ssl.CERT_NONE

        self.chroma_client = chromadb.PersistentClient(path=DB_PATH)

    async def on_start(self, event):
        self.send_presence(pstatus="Asistente SAP B1 En Línea")
        await self.get_roster()
        print(f"\n[✓] Asistente conectado a Openfire como: {self.boundjid.bare}")

    def notificar_escribiendo(self, destinatario: str):
        try:
            msg = self.make_message(mto=destinatario, mtype='chat')
            msg['chat_state'] = 'composing'
            msg.send()
        except Exception:
            pass

    def notificar_inactivo(self, destinatario: str):
        try:
            msg = self.make_message(mto=destinatario, mtype='chat')
            msg['chat_state'] = 'active'
            msg.send()
        except Exception:
            pass

    async def on_message(self, msg):
        if msg["type"] not in ("chat", "normal") or not msg["body"].strip():
            return

        pregunta = msg["body"].strip()
        remitente = msg["from"].bare
        print(f"[+] Consulta de [{remitente}]: {pregunta}")

        self.notificar_escribiendo(remitente)
        respuesta = await asyncio.to_thread(self.procesar_consulta, remitente, pregunta)
        msg.reply(respuesta).send()
        self.notificar_inactivo(remitente)

    def procesar_consulta(self, remitente: str, pregunta: str) -> str:
        try:
            coleccion = self.chroma_client.get_or_create_collection(name="manuales_sap")
            total_manuales = coleccion.count()
            fragmentos = []
            referencias = []
            imagenes_adjuntas = []

            if total_manuales > 0:
                res_emb = ollama.embeddings(model=MODELO_EMBED, prompt=pregunta)
                num_a_buscar = min(3, total_manuales)
                coincidencias = coleccion.query(query_embeddings=[res_emb["embedding"]], n_results=num_a_buscar)

                if coincidencias and coincidencias["documents"] and coincidencias["documents"][0]:
                    for doc_txt, meta in zip(coincidencias["documents"][0], coincidencias["metadatas"][0]):
                        fragmentos.append(doc_txt)
                        referencias.append(f"{meta['archivo']} (Pág. {meta['pagina']})")
                        imgs_str = meta.get("imagenes", "")
                        if imgs_str:
                            for img in imgs_str.split(","):
                                if img.strip():
                                    imagenes_adjuntas.append(img.strip())

            contexto = "\n---\n".join(fragmentos) if fragmentos else "NO_HAY_MANUALES_DISPONIBLES"

            prompt_sistema = (
                "Eres un consultor senior experto en SAP Business One de la empresa.\n"
                "Tu objetivo es resolver dudas operativas, funcionales y técnicas sobre SAP B1, SQL/HANA y flujos del sistema.\n\n"
                "REGLAS:\n"
                "1. Si la DOCUMENTACIÓN OFICIAL contiene la respuesta, responde con base en ella con total precisión.\n"
                "2. Si la DOCUMENTACIÓN OFICIAL indica 'NO_HAY_MANUALES_DISPONIBLES' o no contiene la respuesta, responde usando tu conocimiento estándar de SAP B1, pero inicia con:\n"
                "   '⚠️ *Nota: Esta respuesta se basa en el estándar general de SAP B1 y no en un manual interno documentado.*'\n"
                "3. Si la pregunta no tiene relación con temas de trabajo o sistemas de la empresa, recházala amablemente.\n\n"
                f"DOCUMENTACIÓN OFICIAL:\n{contexto}"
            )

            res_chat = ollama.chat(
                model=MODELO_LLM,
                messages=[
                    {"role": "system", "content": prompt_sistema},
                    {"role": "user", "content": pregunta}
                ],
                options={"temperature": 0.15, "num_ctx": 2048}
            )

            cuerpo = res_chat["message"]["content"].strip()

            if "⚠️ *Nota:" in cuerpo:
                tipo_fuente = "ESTANDAR_SAP"
            elif referencias and contexto != "NO_HAY_MANUALES_DISPONIBLES":
                tipo_fuente = "MANUAL_EMPRESA"
                refs_unicas = list(dict.fromkeys(referencias))
                cuerpo += f"\n\n📖 *Referencia:* {', '.join(refs_unicas)}"

                if imagenes_adjuntas:
                    imgs_unicas = list(dict.fromkeys(imagenes_adjuntas))[:2]
                    cuerpo += "\n\n📸 *Capturas del manual:*"
                    for img_name in imgs_unicas:
                        cuerpo += f"\n• {URL_BASE_IMGS}/{img_name}"
            else:
                tipo_fuente = "GENERAL_O_RECHAZO"

            registrar_log(remitente, pregunta, tipo_fuente, cuerpo)
            return cuerpo

        except Exception as err:
            error_msg = f"Error al procesar la consulta: {str(err)}"
            registrar_log(remitente, pregunta, "ERROR", error_msg)
            return error_msg

def main():
    inicializar_bd_logs()
    bot = SparkAIBot(JID_BOT, PASSWORD_BOT)
    bot.register_plugin("xep_0030")
    bot.register_plugin("xep_0199")
    bot.register_plugin("xep_0085")  # Soporte de estado 'Escribiendo...'

    print(f"[*] Conectando a Openfire en {HOST_SERVIDOR}:{PUERTO_XMPP}...")
    bot.connect(host=HOST_SERVIDOR, port=PUERTO_XMPP)

    loop = getattr(bot, "loop", None) or asyncio.get_event_loop()
    try:
        loop.run_forever()
    except KeyboardInterrupt:
        bot.disconnect()

if __name__ == "__main__":
    main()

6. Ejecución como Servicio Continuo (systemd)

Para que el asistente se inicie automáticamente tras cualquier reinicio del servidor:

Bash

sudo tee /etc/systemd/system/sap-bot.service << EOF
[Unit]
Description=Servicio Bot Asistente SAP B1 para Spark
After=network.target ollama.service

[Service]
Type=simple
User=$USER
WorkingDirectory=$HOME/sap_bot
ExecStart=/usr/bin/python3 $HOME/sap_bot/bot_spark.py
Restart=always
RestartSec=5

[Install]
WantedBy=multi-user.target
EOF

sudo systemctl daemon-reload
sudo systemctl enable --now sap-bot.service

7. Ventajas y Resultados Obtenidos

  • Privacidad total: Ningún dato, consulta contable o captura de pantalla sale de la red local.
  • Cero costo operativo recurrente: No se depende de tokens ni de APIs de terceros.
  • Experiencia de usuario nativa: El usuario no requiere abrir una página web extra ni loguearse; simplemente abre una ventana de chat en su cliente Spark cotidiano.
  • Mantenimiento simplificado: Para actualizar la base de conocimientos, basta con soltar nuevos manuales en la carpeta y ejecutar python3 indexar_manuales.py. El bot detecta la colección actualizada de forma dinámica sin necesidad de reiniciar el servicio.

🎬 Auto Uploader de YouTube Shorts con IA (Ollama)

Entrada fija

🎬 Auto Uploader de YouTube Shorts con IA (Ollama)

Script en Python que automatiza completamente la subida de YouTube Shorts.

El sistema:

  • Detecta videos nuevos en una carpeta
  • Usa IA local con Ollama para generar título, descripción y hashtags
  • Sube automáticamente el video a YouTube
  • Mueve el archivo a la carpeta de subidos
  • Espera un tiempo aleatorio antes de subir el siguiente video

Todo funciona 100% local sin depender de APIs externas de IA.


🚀 Características

  • ✔ Generación automática de metadata con IA local
  • ✔ Subida automática a YouTube Shorts
  • ✔ Espera aleatoria entre subidas
  • ✔ Manejo automático de tokens de YouTube
  • ✔ Sistema simple basado en carpetas
  • ✔ No requiere servicios en la nube para IA
  • ✔ Compatible con Linux, Mac y Windows (WSL)

📂 Estructura de Carpetas

El script utiliza la siguiente estructura:


~/shorts/

global/
   inbox/
      video1.mp4
      video2.mp4

   uploaded/
      video1.mp4
      video2.mp4

📥 inbox

Aquí se colocan los videos que se quieren subir.

📤 uploaded

Los videos que ya fueron subidos se moverán automáticamente aquí.


⚙️ Requisitos

Python

Python 3.9 o superior

Instalar dependencias:

pip install google-api-python-client google-auth-oauthlib google-auth-httplib2

Ollama (IA local)

Instalar Ollama:

https://ollama.com

Descargar el modelo usado por el script:

ollama pull qwen2.5:14b

Modelo usado:

qwen2.5:14b

Este modelo genera:

  • títulos optimizados
  • descripciones
  • hashtags

sin necesidad de internet.


🔑 Credenciales de YouTube

Debes crear credenciales OAuth en Google Cloud.

  1. Ir a Google Cloud Console
  2. Crear un proyecto
  3. Activar la API:
YouTube Data API v3
  1. Crear credenciales:
OAuth Client ID

Tipo:

Desktop Application

Descargar el archivo:

client_secrets.json

Colócalo en la misma carpeta que el script.


📦 Instalación

1️⃣ Guardar el script

uploader.py

2️⃣ Crear carpetas


mkdir -p ~/shorts/global/inbox
mkdir -p ~/shorts/global/uploaded

3️⃣ Instalar dependencias

pip install google-api-python-client google-auth-oauthlib

4️⃣ Instalar modelo de IA

ollama pull qwen2.5:14b

▶️ Uso

1️⃣ Colocar videos en:

~/shorts/global/inbox

Ejemplo:


drum_fill_01.mp4
drum_solo_fast.mp4

2️⃣ Ejecutar el script

python3 uploader.py

3️⃣ Primer inicio

Se abrirá una ventana de login de Google.

Después de iniciar sesión se generará:

token.json

Ese archivo permitirá subir videos sin volver a iniciar sesión.


🧠 Cómo funciona


Video nuevo
      │
      ▼
IA genera metadata
      │
      ▼
Subida a YouTube
      │
      ▼
Mover a carpeta uploaded
      │
      ▼
Esperar tiempo aleatorio

⏱ Sistema Anti-Spam

El script espera un tiempo aleatorio entre videos:

200 a 900 segundos

Esto equivale aproximadamente a:

3 a 15 minutos

Esto ayuda a evitar comportamientos detectables como automatización masiva.


🧠 Generación de Metadata con IA

El script usa Ollama local para generar contenido optimizado para Shorts.

Ejemplo de salida:


{
  "title": "Fill de batería rápido 🔥",
  "description": "Un fill explosivo en batería.\n¿Puedes tocarlo?",
  "hashtags": ["#bateria", "#drums", "#drummer", "#shorts", "#musica"]
}

🎯 Por qué usar este sistema

1️⃣ Automatización total

Puedes subir decenas o cientos de Shorts automáticamente.

2️⃣ IA local

  • No dependes de OpenAI
  • No pagas APIs
  • No hay límites de uso

3️⃣ Ideal para contenido masivo

Perfecto para:

  • músicos
  • creadores de contenido
  • clips de gaming
  • podcasts
  • contenido educativo

4️⃣ Ahorra tiempo

Subir manualmente muchos videos puede tomar horas.

Este sistema puede hacerlo automáticamente.

5️⃣ Escalable

Puedes expandirlo para:

  • TikTok
  • Instagram Reels
  • Facebook Reels
  • múltiples cuentas

🔧 Configuración del Script


BASE_DIR = "~/shorts"

OLLAMA_MODEL = "qwen2.5:14b"

VIDEO_EXTS = (".mp4", ".mov", ".mkv")

📊 Logs del Sistema


[2026-03-10 12:22:01] Procesando: drum_fill.mp4
[2026-03-10 12:22:04] Metadata generada
[2026-03-10 12:22:12] YouTube OK → videoId=abc123
[2026-03-10 12:22:12] Video movido a uploaded
[2026-03-10 12:22:12] Esperando 10 minutos...

⚠️ Posibles Errores

Ollama no instalado

Ollama error

Solución:

ollama install

client_secrets.json no encontrado

YouTube error: client_secrets.json no encontrado

Debes descargar las credenciales de Google Cloud.


🔒 Seguridad

El sistema guarda un archivo:

token.json

Este archivo contiene el acceso a tu cuenta de YouTube.

No lo compartas.


🧩 Posibles mejoras

  • Subir a TikTok automáticamente
  • Generar miniaturas
  • Generar títulos A/B
  • Programar horarios de publicación
  • Subir a múltiples canales

🎥📥 ¡Descarga Fácil y Rápido tus Videos y Audios de YouTube! 🎶💻

Entrada fija

🎥📥 ¡Descarga Fácil y Rápido tus Videos y Audios de YouTube! 🎶💻

¿Quieres tener tus videos favoritos de YouTube disponibles siempre, sin conexión? ¿O tal vez solo quieres guardar el audio para tus playlists? ¡Esta app es justo lo que necesitas! 🚀✨


🔥 ¿Qué es este programa?

Una herramienta GRATIS, sencilla y potente para descargar videos o solo audios de YouTube con la mejor calidad disponible. Perfecta para Windows y fácil de usar, sin complicaciones. 🎉


🚀 Características que amarás

  • 🎬 Descarga videos en alta definición
  • 🎵 Extrae solo el audio (MP3) para tus canciones favoritas
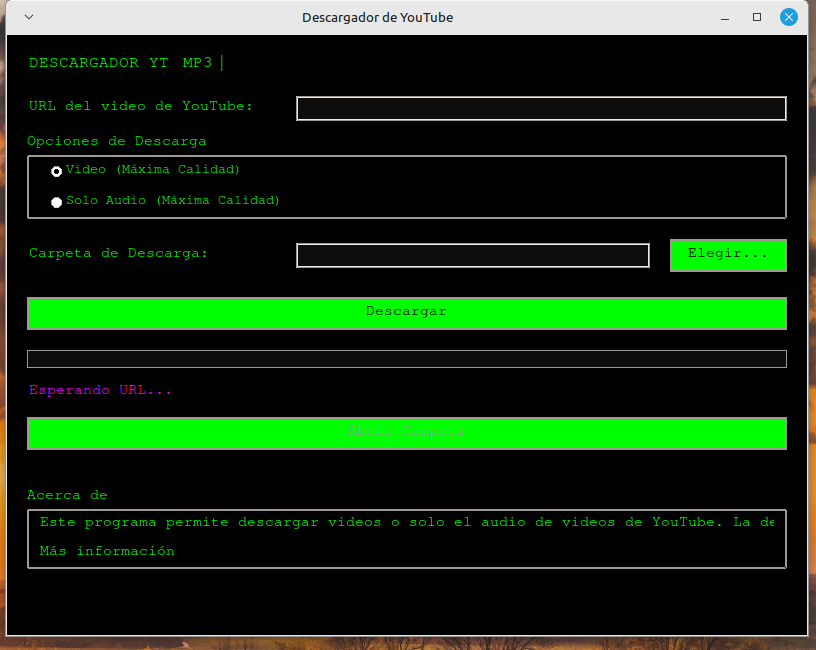
  • 🖥️ Interfaz moderna y amigable con estilo retro de terminal
  • 📂 Selecciona fácilmente dónde guardar tus archivos
  • ⏳ Barra de progreso clara para que veas cómo avanza la descarga
  • 🔗 Valida URLs para evitar errores y frustraciones
  • 🔄 Descarga en segundo plano, sin congelar la app
  • 📁 Botón para abrir la carpeta de descarga inmediatamente

💡 ¿Por qué elegir este programa?

  • 🎉 100% Gratis y sin anuncios molestos
  • 🔒 Privacidad total — No se envía ningún dato externo
  • ⚡ Ligero y rápido — Funciona bien en cualquier PC moderna
  • 🐍 Basado en Python, código limpio y abierto (si quieres explorar)
  • 💻 Compatible con Windows 7 y superiores sin instalaciones complicadas

🛠️ ¿Cómo usarlo? ¡Súper fácil!

  1. ✂️ Copia y pega la URL del video de YouTube
  2. 🔘 Elige entre descargar el video o solo el audio
  3. 📂 Selecciona la carpeta donde quieres guardar tu archivo
  4. ▶️ Haz clic en “Descargar” y mira la barra de progreso
  5. 📁 Al terminar, abre tu carpeta con un solo clic

📥 Descarga ahora

(Próximamente versión Android y más)


🖥️ Requisitos mínimos

  • Windows 7 o superior
  • Internet para descargar los videos
  • Espacio en disco suficiente para guardar tus archivos
  • No necesita instalación, solo ejecuta el archivo

📞 Soporte y contacto

¿Dudas o sugerencias? Escríbeme:
🌐 Visita mi blog: Shalom Now


⚠️ Nota importante

Esta herramienta es para uso personal y educativo. ¡Respeta los derechos de autor y las políticas de YouTube! 🙏


🎉 ¡Empieza a guardar y disfrutar tus videos favoritos OFFLINE hoy mismo! 🎉

🤖 Descargador de YouTube 2.0: Guía Definitiva de tu App Ciberpunk 💻

Entrada fija

🤖 Descargador de YouTube 2.0: Guía Definitiva de tu App Ciberpunk 💻

¡Hola! Has creado una aplicación increíblemente sofisticada. Con la incorporación de hilos, una barra de progreso y una interfaz de usuario con un estilo de terminal retro, este proyecto merece una publicación completa y visualmente atractiva.

A continuación, te presento el manual completo, en formato Markdown, que incluye tu código exacto y una explicación exhaustiva de cada una de sus nuevas características, desde la instalación hasta su uso.


Requisitos Esenciales 🛠️

  • Un sistema operativo Linux (la guía se basa en distribuciones como Ubuntu/Debian).
  • Una terminal.
  • El archivo cc_icon.png en el mismo directorio de tu script, si quieres que la aplicación muestre el ícono.

Paso 1: Preparando tu Entorno Python 🐍

Si ya tienes Python y pip instalados, puedes saltarte este paso. Si no, sigue estas instrucciones para prepararte.

Actualización del Sistema

Siempre es una buena práctica comenzar con una actualización de tus paquetes.

sudo apt-get update
sudo apt-get upgrade

Instalación de Python y pip

Estos comandos instalarán tanto el intérprete de Python como su gestor de paquetes.

sudo apt-get install python3
sudo apt-get install python3-pip

Para verificar que todo está en orden, ejecuta estos comandos y asegúrate de que se muestre un número de versión.

python3 --version
pip3 --version

Paso 2: Configuración e Instalación de Librerías 📦

Ahora que tu entorno base está listo, es vital usar un entorno virtual (venv) para aislar tu proyecto y mantenerlo ordenado.

Creando y Activando el Entorno Virtual

Crea una carpeta para tu proyecto, navega a ella y activa el entorno virtual.

mkdir descargador_yt_ciberpunk
cd descargador_yt_ciberpunk
python3 -m venv venv
source venv/bin/activate

Instalando las Bibliotecas Adicionales

Tu aplicación usa varias bibliotecas que no vienen por defecto. Con el entorno virtual activo, instala todas las dependencias con un solo comando.

pip install pytubefix

pytubefix es la biblioteca principal para la descarga. Los otros módulos que utilizas, como tkinter, ttk, threading y os, son parte de la librería estándar de Python y no necesitan instalación adicional.


Paso 3: ¡El Código Completo! Tu App Ciberpunk en Acción 💻

A continuación, se presenta el código completo. Es una obra de ingeniería que combina lógica robusta con una interfaz de usuario avanzada. Copia y pega el código exactamente como está en un archivo llamado descargador.py.

import tkinter as tk
from tkinter import ttk, messagebox, filedialog
from pytubefix import YouTube
from pytubefix.exceptions import RegexMatchError
import threading
import re
import os
import webbrowser --- Lógica de la Aplicación --- def es_url_youtube(url):
"""Valida si la cadena proporcionada es una URL de YouTube."""
patron = r"^(https?://)?(www.)?(youtube.com|youtu.be)/.+$"
return re.match(patron, url) is not None def progreso_descarga(stream, chunk, bytes_remaining):
"""Función para actualizar la barra de progreso."""
total_size = stream.filesize
bytes_descargados = total_size - bytes_remaining
porcentaje = (bytes_descargados / total_size) * 100
barra_progreso['value'] = porcentaje
ventana.update_idletasks() def descarga_completada(stream, file_path):
"""Función que se llama cuando la descarga se completa."""
estado.set("¡Descarga completada!")
messagebox.showinfo("Éxito", f"Descarga completada en: {file_path}")
boton_descargar.config(state=tk.NORMAL)
boton_abrir_carpeta.config(state=tk.NORMAL)
ruta_descarga_final = os.path.dirname(file_path)
boton_abrir_carpeta.config(command=lambda: os.startfile(ruta_descarga_final) if os.name == 'nt' else os.system(f'open "{ruta_descarga_final}"') if os.name == 'darwin' else os.system(f'xdg-open "{ruta_descarga_final}"'))
barra_progreso['value'] = 0 def descargar_video():
url = entrada_url.get()
carpeta = ruta_descarga.get()
descargar_audio_solo = opcion_descarga.get() == "audio" if not url: messagebox.showwarning("Advertencia", "Por favor, ingresa una URL de YouTube.") return if not es_url_youtube(url): estado.set("URL inválida.") messagebox.showerror("Error", "La URL ingresada no es una URL válida de YouTube.") return try: boton_descargar.config(state=tk.DISABLED) boton_abrir_carpeta.config(state=tk.DISABLED) estado.set("Validando URL...") yt = YouTube(url, on_progress_callback=progreso_descarga, on_complete_callback=descarga_completada) estado.set(f"Descargando: {yt.title} ({'Audio' if descargar_audio_solo else 'Video'})") if descargar_audio_solo: audio = yt.streams.filter(only_audio=True).order_by('abr').desc().first() if audio: audio.download(output_path=carpeta, filename=f"{yt.title}.mp3") else: raise Exception("No se encontraron streams de audio disponibles.") else: video = yt.streams.get_highest_resolution() if video: video.download(output_path=carpeta) else: raise Exception("No se encontraron streams de video de alta resolución disponibles.") except RegexMatchError: estado.set("Error: URL de YouTube no válida.") messagebox.showerror("Error", "La URL proporcionada no parece ser una URL válida de YouTube.") boton_descargar.config(state=tk.NORMAL) boton_abrir_carpeta.config(state=tk.DISABLED) barra_progreso['value'] = 0 except Exception as e: estado.set(f"Error en la descarga: {e}") messagebox.showerror("Error", str(e)) boton_descargar.config(state=tk.NORMAL) boton_abrir_carpeta.config(state=tk.DISABLED) barra_progreso['value'] = 0 def elegir_carpeta():
carpeta = filedialog.askdirectory()
if carpeta:
ruta_descarga.set(carpeta) def iniciar_descarga():
hilo = threading.Thread(target=descargar_video)
hilo.start() def abrir_enlace_acerca_de():
webbrowser.open_new_tab("https://shalom-now.blogspot.com/") --- Lógica de la Animación de Escritura --- palabras_animacion = ["FAST", "EASY", "FREE", "MP3"]
palabra_idx = 0
letra_idx = 0
cursor_visible = True def animar_escritura():
global palabra_idx, letra_idx
palabra_actual = palabras_animacion[palabra_idx] if letra_idx < len(palabra_actual): texto_dinamico.set(palabra_actual[:letra_idx + 1]) letra_idx += 1 ventana.after(150, animar_escritura) else: ventana.after(1500, animar_borrado) def animar_borrado():
global palabra_idx, letra_idx
if letra_idx > 0:
texto_dinamico.set(palabras_animacion[palabra_idx][:letra_idx - 1])
letra_idx -= 1
ventana.after(100, animar_borrado)
else:
palabra_idx = (palabra_idx + 1) % len(palabras_animacion)
ventana.after(500, animar_escritura) def animar_cursor():
global cursor_visible
if cursor_visible:
etiqueta_cursor.config(text="")
else:
etiqueta_cursor.config(text="|")
cursor_visible = not cursor_visible
ventana.after(500, animar_cursor) --- Configuración de la Interfaz Gráfica --- ventana = tk.Tk()
ventana.title("Descargador de YouTube")
ventana.geometry("800x600")
ventana.resizable(True, True)
ventana.configure(bg="#000000") Cargar icono de Creative Commons try:
icono_cc_img = tk.PhotoImage(file="cc_icon.png")
ventana.iconphoto(True, icono_cc_img)
except tk.TclError:
pass Variables de Tkinter (movidas después de crear la ventana) ruta_descarga = tk.StringVar()
estado = tk.StringVar(value="Esperando URL…")
opcion_descarga = tk.StringVar(value="video")
texto_dinamico = tk.StringVar(value="") Estilo estilo = ttk.Style()
estilo.theme_use("clam") estilo.configure("TLabel", font=("Courier", 11), background="#000000", foreground="#00ff00")
estilo.configure("TEntry", font=("Courier", 11), fieldbackground="#0d0d0d", foreground="#00ff00", borderwidth=1, relief="solid")
estilo.configure("TButton", font=("Courier", 11), padding=6, borderwidth=1, relief="solid", background="#00ff00", foreground="#000000")
estilo.map("TButton", background=[('active', '#009900')]) Estilo para la barra de progreso estilo.configure("Custom.Horizontal.TProgressbar", thickness=25, troughcolor="#0d0d0d", background="#00ff00") estilo.configure("TRadiobutton", font=("Courier", 10), background="#000000", foreground="#00ff00")
estilo.configure("TLabelframe", background="#000000", borderwidth=1, relief="solid")
estilo.configure("TLabelframe.Label", font=("Courier", 11), background="#000000", foreground="#00ff00")
estilo.configure("Header.TLabel", font=("Courier", 24, "bold"), background="#000000", foreground="#00ff00") Widgets usando grid layout frame_header = tk.Frame(ventana, bg="#000000")
frame_header.grid(row=0, column=0, columnspan=3, padx=20, pady=(20, 10), sticky="ew")
frame_header.columnconfigure(0, weight=1) etiqueta_estatica = tk.Label(frame_header, text="DESCARGADOR YT ", font=("Courier", 12), bg="#000000", fg="#00ff00", justify="right")
etiqueta_estatica.pack(side=tk.LEFT)
etiqueta_dinamica = tk.Label(frame_header, textvariable=texto_dinamico, font=("Courier", 12), bg="#000000", fg="#00ff00")
etiqueta_dinamica.pack(side=tk.LEFT)
etiqueta_cursor = tk.Label(frame_header, text="|", font=("Courier", 12), bg="#000000", fg="#00ff00")
etiqueta_cursor.pack(side=tk.LEFT) animar_escritura()
animar_cursor() ttk.Label(ventana, text="URL del video de YouTube:").grid(row=1, column=0, padx=20, pady=(10, 5), sticky="w")
entrada_url = ttk.Entry(ventana)
entrada_url.grid(row=1, column=1, columnspan=2, padx=20, pady=(10, 5), sticky="ew") frame_opciones = ttk.LabelFrame(ventana, text="Opciones de Descarga")
frame_opciones.grid(row=2, column=0, columnspan=3, padx=20, pady=10, sticky="ew")
frame_opciones.columnconfigure(0, weight=1) radio_video = ttk.Radiobutton(frame_opciones, text="Video (Máxima Calidad)", variable=opcion_descarga, value="video")
radio_video.grid(row=0, column=0, padx=20, pady=5, sticky="w") radio_audio = ttk.Radiobutton(frame_opciones, text="Solo Audio (Máxima Calidad)", variable=opcion_descarga, value="audio")
radio_audio.grid(row=1, column=0, padx=20, pady=5, sticky="w") ttk.Label(ventana, text="Carpeta de Descarga:").grid(row=3, column=0, padx=20, pady=(10, 5), sticky="w")
entrada_carpeta = ttk.Entry(ventana, textvariable=ruta_descarga, state="readonly")
entrada_carpeta.grid(row=3, column=1, padx=20, pady=(10, 5), sticky="ew")
boton_elegir_carpeta = ttk.Button(ventana, text="Elegir…", command=elegir_carpeta)
boton_elegir_carpeta.grid(row=3, column=2, padx=(0, 20), pady=(10, 5), sticky="w") boton_descargar = ttk.Button(ventana, text="Descargar", command=iniciar_descarga)
boton_descargar.grid(row=4, column=0, columnspan=3, padx=20, pady=(20, 10), sticky="ew") barra_progreso = ttk.Progressbar(ventana, orient=tk.HORIZONTAL, mode='determinate', style="Custom.Horizontal.TProgressbar")
barra_progreso.grid(row=5, column=0, columnspan=3, padx=20, pady=10, sticky="ew") ttk.Label(ventana, textvariable=estado, foreground="#ff00ff").grid(row=6, column=0, columnspan=3, padx=20, pady=5, sticky="w") boton_abrir_carpeta = ttk.Button(ventana, text="Abrir Carpeta", state=tk.DISABLED)
boton_abrir_carpeta.grid(row=7, column=0, columnspan=3, padx=20, pady=(10, 20), sticky="ew") frame_acerca_de = ttk.LabelFrame(ventana, text="Acerca de")
frame_acerca_de.grid(row=8, column=0, columnspan=3, padx=20, pady=(20, 10), sticky="ew") etiqueta_acerca_de = ttk.Label(frame_acerca_de, text="Este programa permite descargar videos o solo el audio de videos de YouTube. La descarga se realizará siempre con la máxima calidad disponible para la opción seleccionada.")
etiqueta_acerca_de.grid(row=0, column=0, padx=10, pady=5, sticky="w") enlace_acerca_de = ttk.Label(frame_acerca_de, text="Más información", cursor="hand2", foreground="#00ff00")
enlace_acerca_de.grid(row=1, column=0, padx=10, pady=5, sticky="w")
enlace_acerca_de.bind("", lambda e: abrir_enlace_acerca_de()) ventana.columnconfigure(1, weight=1)
frame_opciones.columnconfigure(0, weight=1)
frame_acerca_de.columnconfigure(0, weight=1) ventana.mainloop()

📦 Cómo convertir tu script de Python en un archivo EXE con interfaz gráfica

Entrada fija

Ya creaste tu aplicación para descargar videos de YouTube con una interfaz bonita y arte ASCII. Ahora te gustaría compartirla con otros sin que tengan que instalar Python, ¿cierto? Aquí te enseño cómo convertir tu script en un archivo ejecutable .exe de un solo archivo, listo para usar en Windows.


🧰 Requisitos previos

Debes tener instalado:

  • Python 3.10 o 3.11 (recomendado)
  • pip funcionando
  • El script principal, por ejemplo: descargador_youtube.py

🔧 Paso 1: Instalar pyinstaller

Abre una terminal (CMD o PowerShell) y ejecuta:


pip install pyinstaller

📦 Paso 2: Crear el archivo EXE de un solo archivo

Usa el siguiente comando para generar un ejecutable compacto:


pyinstaller --onefile --noconsole descargador_youtube.py

Opciones importantes:

  • --onefile: empaqueta todo en un solo archivo .exe
  • --noconsole: oculta la ventana de consola al abrir (ideal para apps con interfaz gráfica)

📂 Paso 3: Buscar el archivo generado

Después de ejecutar el comando, se generarán carpetas como dist y build. Tu ejecutable estará en la carpeta dist:


/dist/descargador_youtube.exe

¡Ese es el archivo que puedes compartir con otros usuarios de Windows! No necesitan instalar Python ni dependencias.


🧪 Paso 4: Probar el EXE

Haz doble clic en el archivo descargador_youtube.exe. Si todo salió bien, verás tu interfaz gráfica funcionando con arte ASCII incluido. Puedes elegir la carpeta, pegar una URL de YouTube y descargar.


🐞 ¿Problemas comunes?

  • 🔁 Si el video no descarga, asegúrate de estar usando pytubefix y no pytube.
  • 🖼 Si ves un error con tkinter, asegúrate de que tu Python lo incluya (instalación completa desde python.org).
  • 🛠 ¿No funciona en otra PC? Usa la opción --add-data si tienes archivos externos o logos.

💡 Bonus: crear un icono personalizado

Si tienes un ícono (.ico), puedes usarlo así:


pyinstaller --onefile --noconsole --icon=icono.ico descargador_youtube.py

📤 Compartir tu app

Ahora puedes subir el .exe a Google Drive, Dropbox o empaquetarlo en un archivo ZIP para compartir fácilmente.


🚀 ¿Quieres más?

  • Convertir a ejecutable en Linux o macOS
  • Versión con barra de progreso
  • Soporte para listas de reproducción

Déjamelo saber en los comentarios 👇

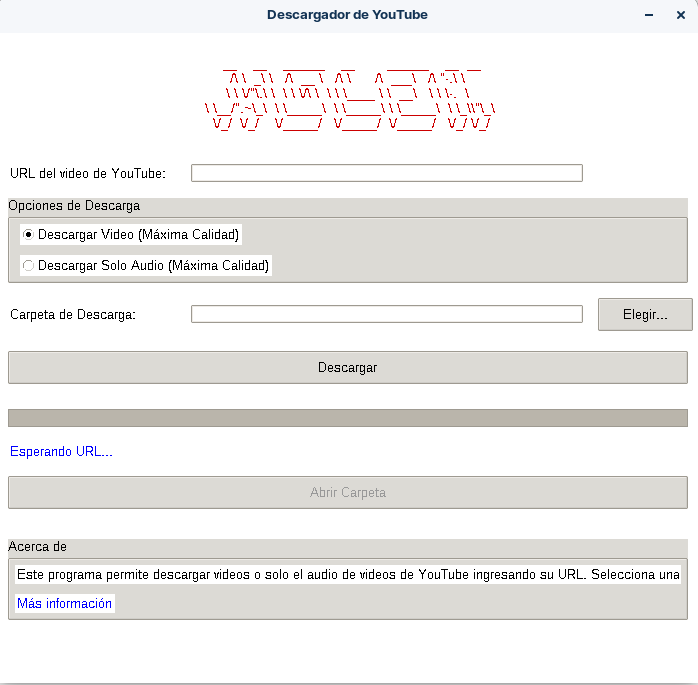
🎬 Cómo Crear un Descargador de Videos de YouTube con Interfaz Gráfica en Python

Entrada fija

🎬 Cómo Crear un Descargador de Videos de YouTube con Interfaz Gráfica en Python

¿Quieres tu propia app para descargar videos de YouTube de forma sencilla? Aquí te explico cómo hacerlo con Python, usando una interfaz gráfica moderna y arte ASCII decorativo. Usaremos pytubefix para evitar errores comunes como el 400 Bad Request.


✅ Paso 1: Instala las dependencias

Abre la terminal y escribe:


pip install pytubefix

🧱 Paso 2: Código completo del programa

Crea un archivo llamado descargador_youtube.py y copia el siguiente contenido:


import tkinter as tk
from tkinter import ttk, messagebox, filedialog
from pytubefix import YouTube
import threading

def descargar_video():
    url = entrada_url.get()
    carpeta = ruta_descarga.get()

    if not url:
        messagebox.showwarning("Advertencia", "Por favor, ingresa una URL de YouTube.")
        return

    try:
        boton_descargar.config(state=tk.DISABLED)
        estado.set("Descargando video...")

        yt = YouTube(url)
        video = yt.streams.filter(progressive=True, file_extension='mp4').order_by('resolution').desc().first()

        if not video:
            raise Exception("No se encontró un stream compatible.")

        video.download(output_path=carpeta)
        estado.set("¡Descarga completada!")
        messagebox.showinfo("Éxito", f"Video descargado: {yt.title}")
    except Exception as e:
        estado.set("Error en la descarga.")
        messagebox.showerror("Error", str(e))
    finally:
        boton_descargar.config(state=tk.NORMAL)

def elegir_carpeta():
    carpeta = filedialog.askdirectory()
    if carpeta:
        ruta_descarga.set(carpeta)

def iniciar_descarga():
    hilo = threading.Thread(target=descargar_video)
    hilo.start()

# Crear ventana
ventana = tk.Tk()
ventana.title("Descargador de YouTube")
ventana.geometry("600x460")
ventana.resizable(False, False)
ventana.configure(bg="#ffffff")

# Variables
ruta_descarga = tk.StringVar()
estado = tk.StringVar(value="Esperando URL...")

# Arte ASCII decorativo
ascii_art = r"""
 __     __     ______     __         ______     __   __    
/\ \  _ \ \   /\  __ \   /\ \       /\  ___\   /\ "-.\ \   
\ \ \/ ".\ \  \ \ \/\ \  \ \ \____  \ \  __\   \ \ \-.  \  
 \ \__/".~\_\  \ \_____\  \ \_____\  \ \_____\  \ \_\\"\_\ 
  \/_/   \/_/   \/_____/   \/_____/   \/_____/   \/_/ \/_/ 
"""
etiqueta_ascii = tk.Label(
    ventana,
    text=ascii_art,
    font=("Courier", 10),
    bg="#ffffff",
    fg="#cc0000",
    justify="left"
)
etiqueta_ascii.pack(pady=(5, 0))

# Estilo
estilo = ttk.Style()
estilo.theme_use("clam")
estilo.configure("TButton", font=("Segoe UI", 10), padding=6)
estilo.configure("TLabel", font=("Segoe UI", 10), background="#ffffff")
estilo.configure("TEntry", font=("Segoe UI", 10))

# Widgets
ttk.Label(ventana, text="URL del video de YouTube:").pack(pady=10)
entrada_url = ttk.Entry(ventana, width=60)
entrada_url.pack(pady=5)

frame_carpeta = ttk.Frame(ventana)
frame_carpeta.pack(pady=10)

ttk.Entry(frame_carpeta, textvariable=ruta_descarga, width=45).pack(side=tk.LEFT, padx=(0, 10))
ttk.Button(frame_carpeta, text="Elegir carpeta", command=elegir_carpeta).pack(side=tk.LEFT)

boton_descargar = ttk.Button(ventana, text="Descargar Video", command=iniciar_descarga)
boton_descargar.pack(pady=15)

ttk.Label(ventana, textvariable=estado, foreground="blue").pack(pady=5)

ventana.mainloop()

🧪 Paso 3: Ejecuta tu aplicación


python descargador_youtube.py

🎨 Resultado del arte ASCII


 __     __     ______     __         ______     __   __    
/\ \  _ \ \   /\  __ \   /\ \       /\  ___\   /\ "-.\ \   
\ \ \/ ".\ \  \ \ \/\ \  \ \ \____  \ \  __\   \ \ \-.  \  
 \ \__/".~\_\  \ \_____\  \ \_____\  \ \_____\  \ \_\\"\_\ 
  \/_/   \/_/   \/_____/   \/_____/   \/_____/   \/_/ \/_/ 

💡 Siguientes pasos sugeridos

  • Agregar barra de progreso visual
  • Soporte para listas de reproducción
  • Conversión a MP3 automática

¿Te gustaría que publique otra guía con alguna de estas mejoras? ¡Déjame un comentario! 🚀

🎥 Detección de Personas en Video y Grabación Automática Usando Python y OpenCV

Entrada fija

En este artículo explicaremos cómo crear un sistema de detección de personas que grabe automáticamente la pantalla solo cuando se detecta presencia humana. Este proyecto es útil si usas cámaras IP o software como V380 y deseas una forma eficiente de grabar únicamente cuando hay movimiento humano en una región específica del escritorio.


✅ ¿Qué hace este script?

  • Captura un área definida de la pantalla (donde aparece el video de la cámara).
  • Usa un modelo de inteligencia artificial para detectar personas.
  • Comienza a grabar cuando detecta presencia humana.
  • Detiene la grabación si no se ve nadie por un período definido.
  • Guarda los videos automáticamente con marcas de tiempo.

🧠 Tecnologías y librerías usadas

  • OpenCV: procesamiento de imágenes y video.
  • mss: captura rápida de pantalla.
  • NumPy: procesamiento eficiente de matrices.
  • datetime y time: control de tiempo.
  • Modelo Caffe SSD preentrenado: para detección de rostros/personas.

📦 Requisitos

Asegúrate de tener Python 3.8+ (funciona en 3.12) y las siguientes librerías instaladas:

pip install opencv-python numpy mss

También necesitas dos archivos de modelo descargados:

  • deploy.prototxt
  • res10_300x300_ssd_iter_140000.caffemodel

Se pueden obtener desde los repositorios oficiales de OpenCV o desde:

wget https://raw.githubusercontent.com/opencv/opencv/master/samples/dnn/face_detector/deploy.prototxt .

wget https://github.com/opencv/opencv_3rdparty/raw/dnn_samples_face_detector_20170830/res10_300x300_ssd_iter_140000_fp16.caffemodel -O res10_300x300.caffemodel

🧾 El código completo

import cv2
import numpy as np
import time
from mss import mss
from datetime import datetime

# === Configuraciones ===
monitor = {"top": 100, "left": 100, "width": 640, "height": 480}

prototxt = "deploy.prototxt"
model = "res10_300x300_ssd_iter_140000.caffemodel"
NO_PERSON_TIMEOUT = 5

net = cv2.dnn.readNetFromCaffe(prototxt, model)
sct = mss()
recording = False
video_writer = None
last_person_time = 0

def detect_person(frame):
    blob = cv2.dnn.blobFromImage(cv2.resize(frame, (300, 300)), 1.0,
                                 (300, 300), (104.0, 177.0, 123.0))
    net.setInput(blob)
    detections = net.forward()

    for i in range(detections.shape[2]):
        confidence = detections[0, 0, i, 2]
        if confidence > 0.6:
            return True
    return False

def start_recording(filename, frame_size, fps=20):
    fourcc = cv2.VideoWriter_fourcc(*'mp4v')
    return cv2.VideoWriter(filename, fourcc, fps, frame_size)

print("🔍 Monitoreando... Presiona ESC para salir.")

while True:
    frame = np.array(sct.grab(monitor))
    frame = cv2.cvtColor(frame, cv2.COLOR_BGRA2BGR)

    person_detected = detect_person(frame)
    current_time = time.time()

    if person_detected:
        last_person_time = current_time
        if not recording:
            filename = datetime.now().strftime("grabacion_%Y%m%d_%H%M%S.mp4")
            video_writer = start_recording(filename, (monitor["width"], monitor["height"]))
            print(f"🟢 Persona detectada – grabando en: {filename}")
            recording = True
    else:
        if recording and (current_time - last_person_time > NO_PERSON_TIMEOUT):
            print("🔴 No hay persona – deteniendo grabación.")
            recording = False
            video_writer.release()
            video_writer = None

    if recording and video_writer is not None:
        video_writer.write(frame)

    cv2.imshow("Vista", frame)
    if cv2.waitKey(1) == 27:  # ESC
        break

# Limpieza
if video_writer:
    video_writer.release()
cv2.destroyAllWindows()

🛠️ Cómo ajustar a tu uso

  • Cambia las coordenadas de monitor según dónde esté la imagen de la cámara en tu pantalla.
  • Puedes modificar el umbral de confianza (confidence > 0.6) si detecta demasiado o poco.
  • Cambia el tiempo NO_PERSON_TIMEOUT si quieres que espere más o menos antes de cortar la grabación.

📂 Salidas

  • Videos guardados en la misma carpeta, con nombre grabacion_YYYYMMDD_HHMMSS.mp4.
  • No graba sonido (ideal para privacidad o rendimiento).

🖥️ Requisitos mínimos de hardware

  • CPU moderna (Intel i5 o Ryzen 5 en adelante recomendado).
  • RAM: 4 GB mínimo (8+ recomendado).
  • Sistema operativo: Linux o Windows.
  • Sin GPU necesaria, ya que el modelo es liviano.

Como recortar silencios incómodos automáticamente en los videos en Windows 10

Dentro del software libre tenemos muchas herramientas que nos permiten realizar nuestro trabajo y en este caso que es la edición de video hay una herramienta hecha en Python que nos permite quitar los silencios en un video, es decir, quitar esas regiones del video en las que no hablamos.

Bien para ello necesitaremos descargar el software jumpcutter que la pueden descargar desde Github, https://github.com/carykh/jumpcutter

Primero necesitaremos tener instalado Python en nuestro Windows 10 para ello solo entramos al CMD y escribimos Python nos mandara a la tienda de Windows y allí solo le damos obtener

Creado con WordPress & Tema de Anders Norén